迁移报告一般长这样,多少张表,多少行,校验和一致,失败记录为零。项目经理拿着报告去问业务,能不能切。业务翻了两页,还是摇头。这份报告证明数据搬过去了,证明不了业务能跑。订单会不会重复,退款会不会卡住,库存会不会扣错,财务能不能对上,报告里都没有答案。业务不敢签字,很多时候卡在这里。
一、数据量对上了,业务动作还没对上
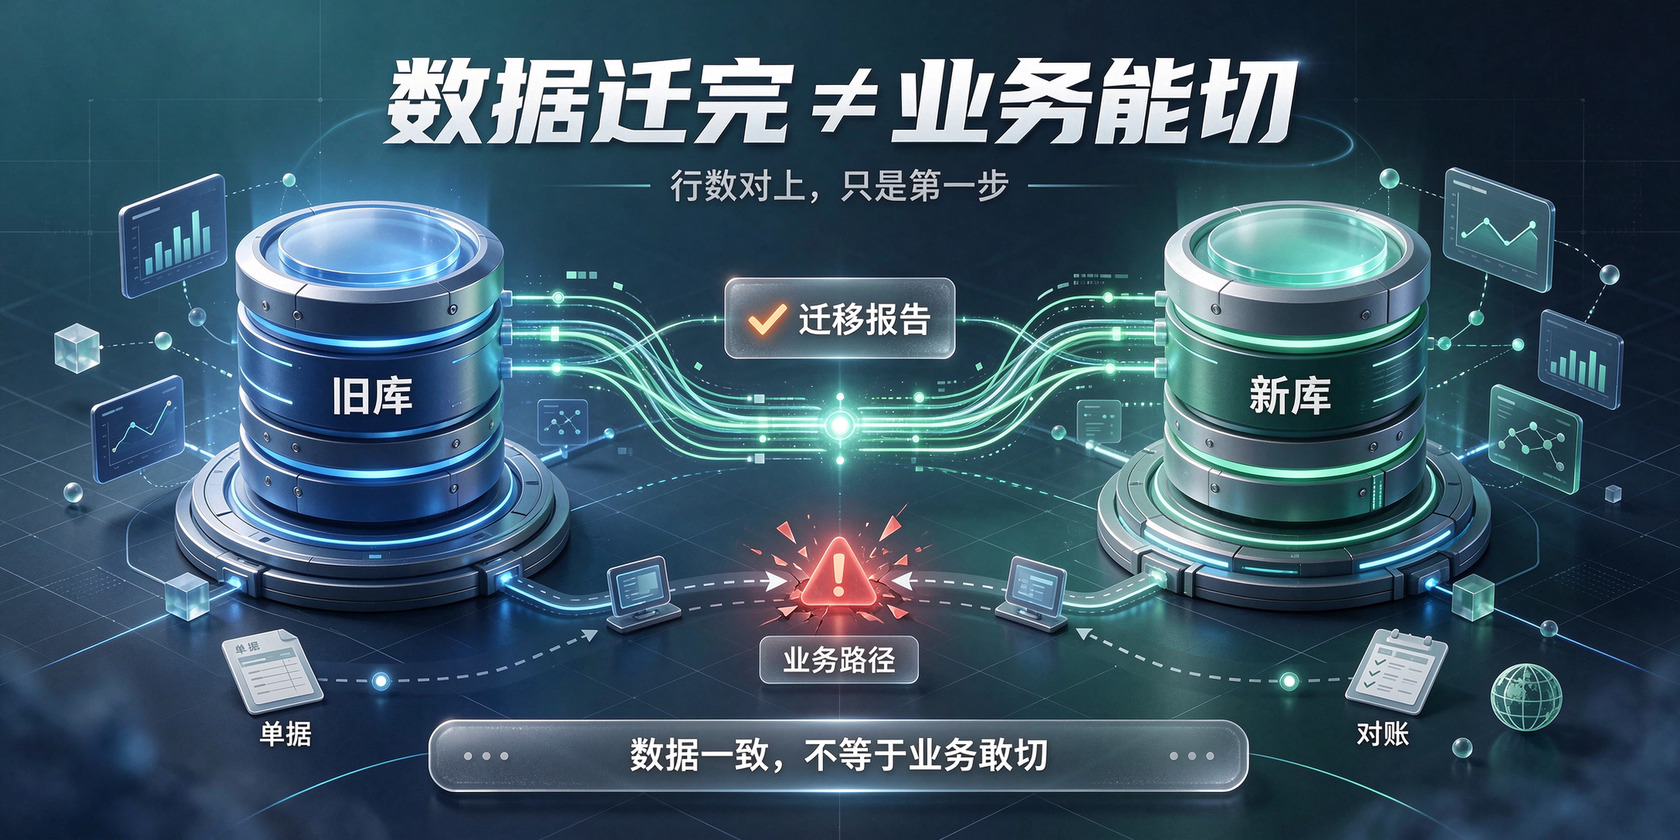
迁移工具最擅长比对行数和校验和。两张表的数据一条不差,迁移报告就会显示通过。可业务关心的是一张单子从下单到退款走完,中间经过哪些表,哪些状态,哪些定时任务。
旧库里的存储过程、触发器、视图、定时任务,迁到新库以后可能语法能编译,逻辑却跑不通。比如订单状态靠触发器往下推,新库没建同名触发器,单子就会停在中间状态。
还有些东西根本不在数据里。打印模板取的是旧库的字段顺序,导出报表写死了旧库的排序规则,财务接口按旧库的时间精度做匹配。数据搬完了,这些配套没搬,业务一用就露馅。
所以迁移前要列一张业务路径清单,下单、支付、退款、撤销、发货、库存扣减、结算、对账、开票,一条一条走。每条路径挑几张真实单据,在旧库跑一遍,在新库跑一遍,把结果摆在一起看。
二、双跑要跑出差异,不能只跑个热闹
双跑经常被理解成两边都开着。旧库接生产,新库也跟着写一份,看起来跑了很久,实际上没人认真对过结果。环境开了,日志也有了,差异表却没人看。
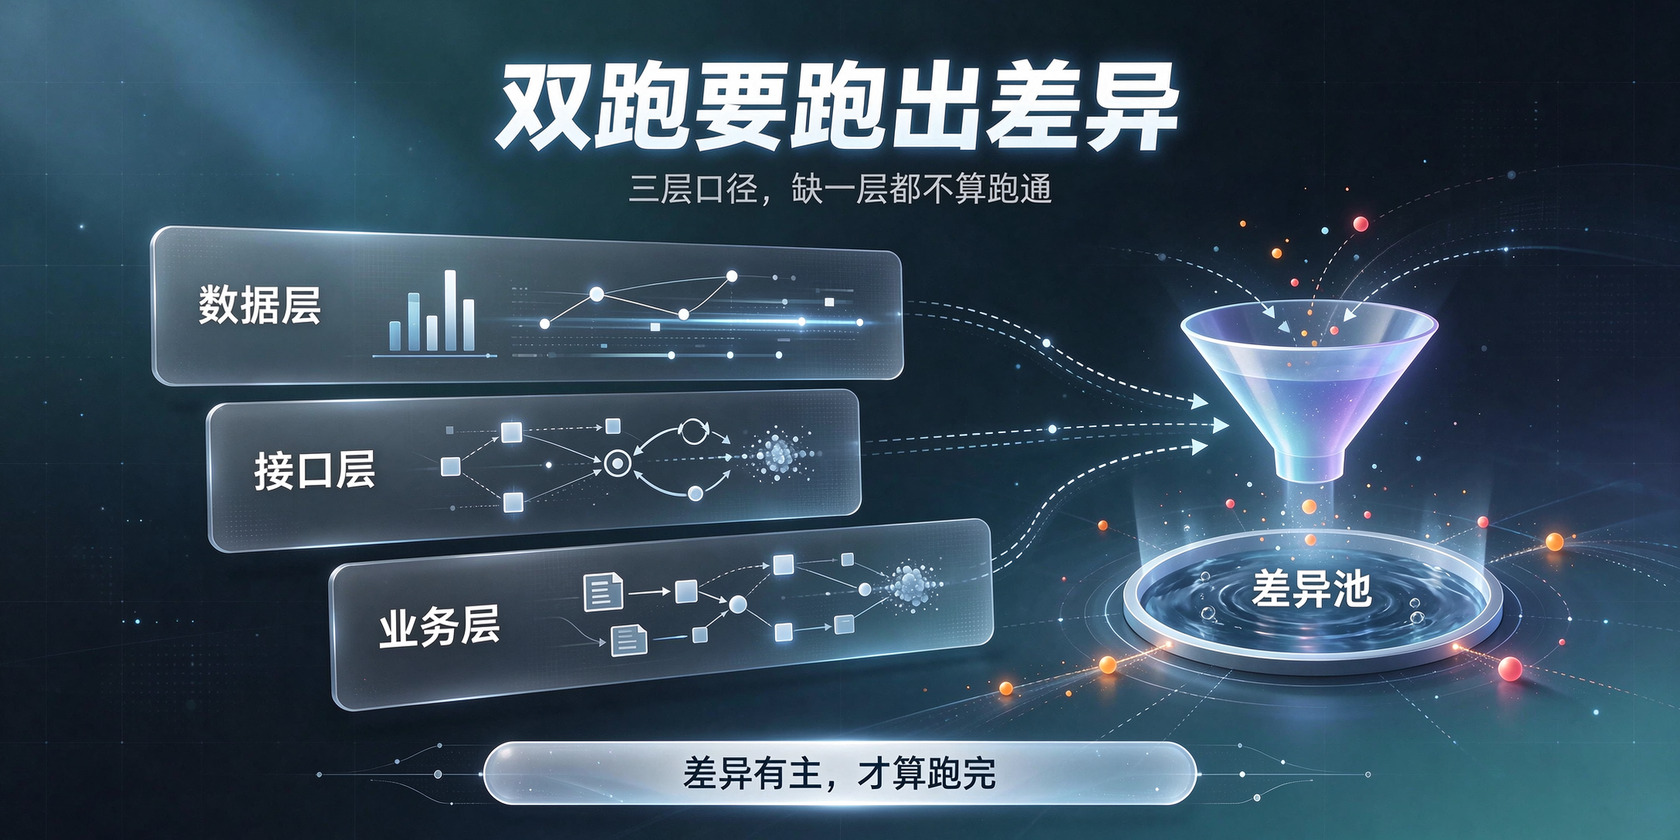
真正有用的双跑,要先定比对口径。数据层看行数、金额、状态、时间戳,接口层看返回码、耗时、错误信息,业务层看单据能不能往下走,库存和账务有没有变化。三层都要有比对规则,不能只看数据库里的行数。
差异出来了,还要分类。哪些是旧库本来就有的脏数据,哪些是新库字段精度不够,哪些是代码逻辑没迁过去,哪些是同步延迟。每类差异要有负责人和关闭时限,不能全部丢给开发。
双跑也要有退出条件。跑完一个完整业务周期,覆盖退款、撤销、冲正、跨天、月末,差异清零或者剩下的都能解释,才可以谈切换。双跑时间拉得再长,也不等于更安全。没有口径的双跑,只是多开一套环境。
三、回滚方案要真演过,不能只写一句可回滚
迁移方案里经常只写一句,保留旧库,出问题切回去。真出事的时候,这句话没法执行。切换期间新库已经产生新数据,直接切回旧库,这段时间的单子就丢了。
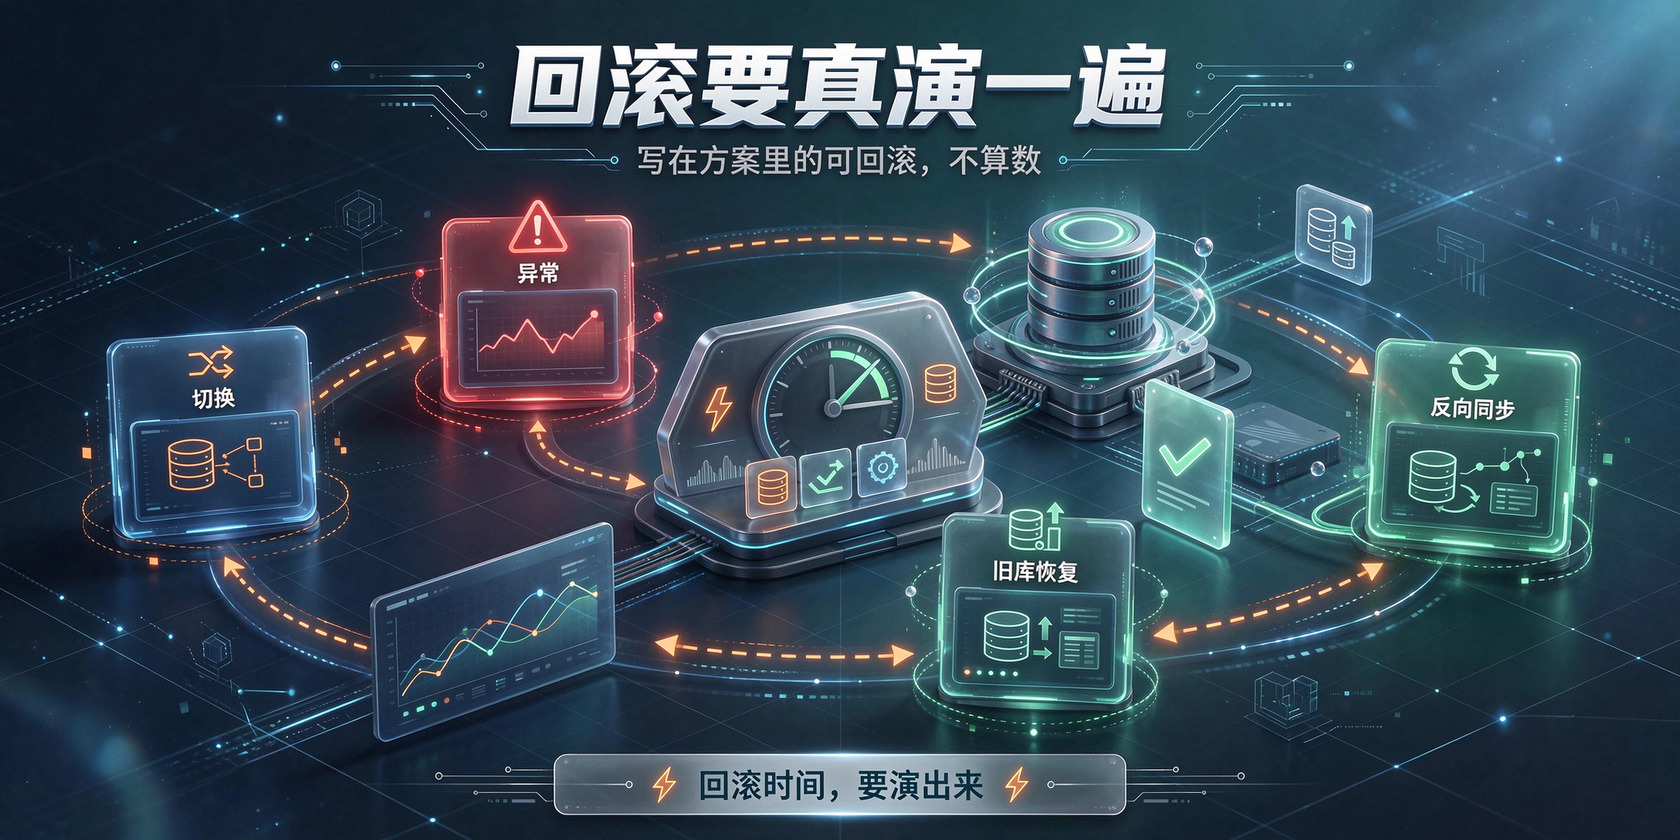
回滚要先解决反向同步。新库写进去的订单、支付、库存、账务,要能回到旧库,或者能在旧库补出来。补偿脚本要幂等,跑一遍和跑十遍结果一样,否则越补越乱。
还要算时间。从发现异常,到拍板回滚,到停写,到反向同步,到旧库恢复服务,每一步多少分钟,谁来做,谁通知业务。这个时间要真演一遍,不能拍脑袋写个预计。
备份也要能恢复。备份文件有没有校验,恢复出来的库能不能启动,索引和权限对不对,这些都要在独立环境里试过。只看到备份成功,不等于恢复成功。
四、切换窗口按业务日历排,不按开发进度排
开发觉得代码写完了,测试也过了,就想尽快切。业务看的却是另一本日历,哪天结算,哪天对账,哪天发薪,哪天有促销,哪天要报税。两边的节奏对不上,切换日期就会一直往后拖。
切换窗口要避开业务高峰,也要避开数据高峰。月末那天,财务在跑结转,门店在盘点,电商在等平台账单,这时候切库,等于把对账动作同时按下暂停。
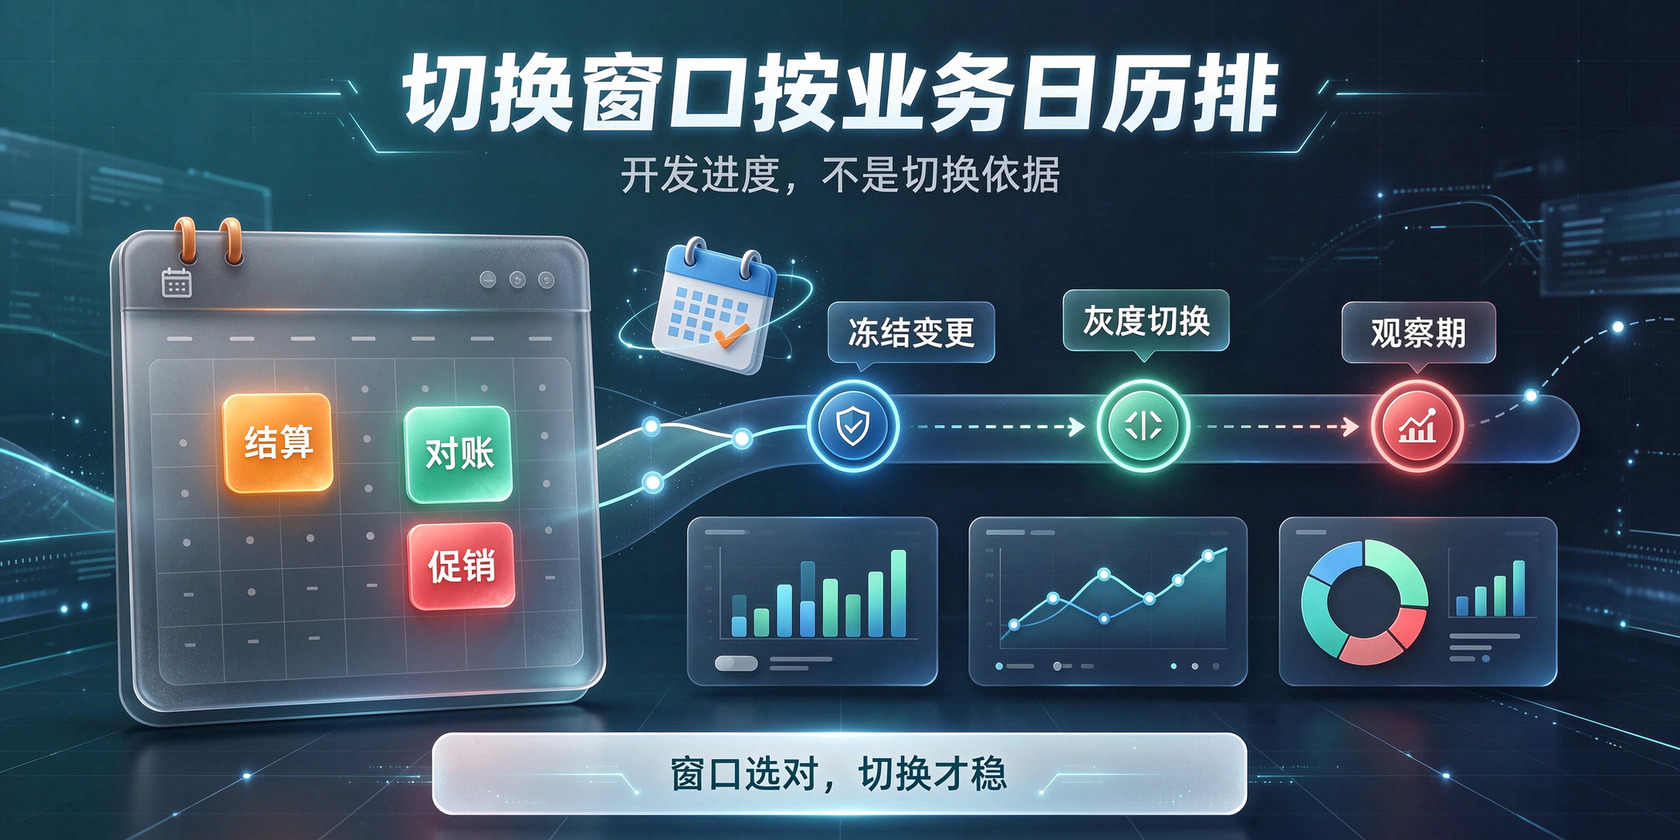
窗口定了以后,要冻结变更。代码封版,数据库停止 DDL,批量任务停跑,接口不再加字段。切换步骤拆到分钟,谁在几点做什么,做完看哪个指标,失败走哪条分支,都写进切换手册。
如果业务等不起一个长窗口,就做灰度。按门店切,按渠道切,按模块切,先让一小部分真实业务走新库。出问题只回退这一部分,旧库和其他业务不受影响。
切换完成也不代表结束。头几天要盯差异报表、慢查询、锁等待、连接数、批处理时长,还要抽查关键单据。第一笔真实订单走完,第一张对账单对平,第一次退款到账,业务才真的敢松口。
数据库迁移真正要交的,不只是新库和迁移报告。业务路径有人走过,双跑差异有人解释,回滚有人演过,切换窗口有人守过,这几样凑齐,业务才敢在切换单上签字。


 在线
 电话
 微信
 需求
 TOP

