前阵子见过一个设备巡检的库,工单表跑了三年,2200 万行。列表页原来两百毫秒,后来点一次要等七八秒,客户催着问是不是该分表了。我先让运维把慢查询日志打开,三天下来排第一的那条 SQL 只查最近一个月、按状态过滤,执行计划里 type 是 ALL,status 上根本没有索引。补了一个联合索引,页面回到两百毫秒以内,分表的事暂时不用提。
这类判断每年都要做好几次。数据量确实在涨,但到两千万行只是个数字,它本身不构成必须拆表的理由。真正要回答的是三个问题,慢在什么地方、增长有多快、拆开之后查询和运维能不能接得住。
一、两千万行本身不慢,慢的是查询方式
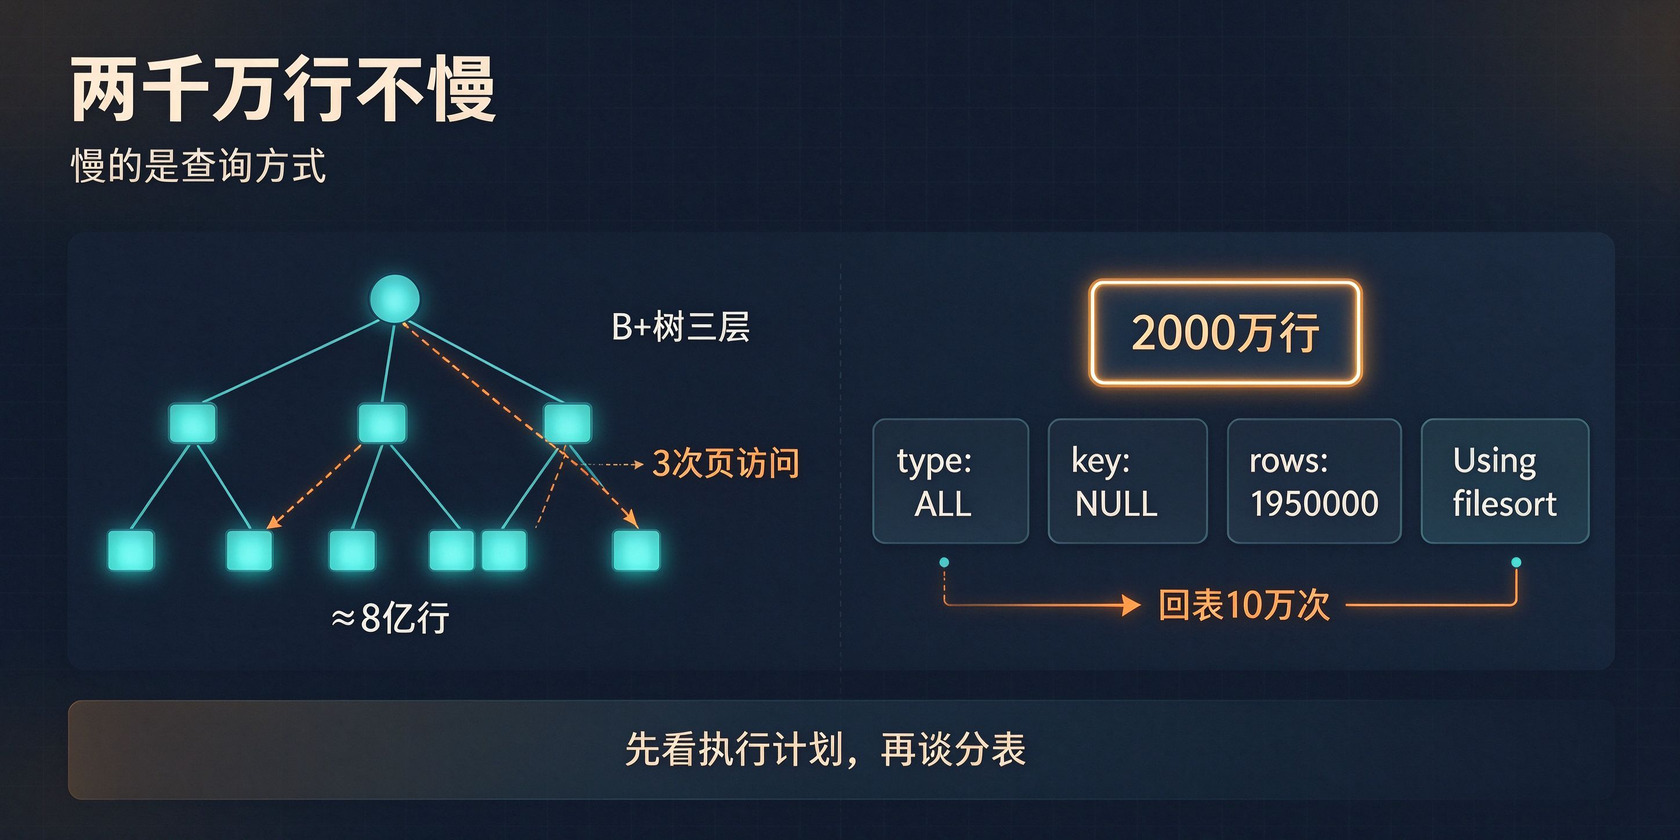
InnoDB 的索引是一棵 B+ 树,页大小 16KB。主键是 bigint,一条索引记录差不多 20 字节,加上页内指针,一个叶子页能放六百多条;上层非叶子页只存键值和页号,一个页能放一千多条。三层算下来,1170 × 1170 × 630,量级在八亿行以上。也就是说 2000 万行的表,走主键或二级索引仍然是三次页访问,和几百万行的表没有本质区别。
所以看到列表页慢,先别把账算在行数上。打开慢查询,拿 EXPLAIN 看四列就够,type 是不是 ALL 或 index,key 是不是 NULL,rows 估算多少,Extra 里有没有 Using filesort、Using temporary。一条按时间范围加状态过滤的查询,如果 type 是 ALL、rows 接近全表,问题在索引不在数据量。
真正容易被忽略的是回表。二级索引只存索引列加主键,查询要的字段不在索引里,每条记录都要回主键树再取一次。查十万行就是十万次回表,缓冲池命中不了就是十万次随机 IO,比全表顺序扫还慢。把列表要用的字段做成覆盖索引,或者干脆把大字段挪到扩展表,效果往往比分表明显。
深分页也是老问题。LIMIT 100000, 20 这种写法,MySQL 要先取出十万零二十行再扔掉前十万行,越往后翻越慢。改成延迟关联,先用覆盖索引拿到主键,再回表取二十条,代价从十万行降到二十行。
SELECT w.id, w.title, w.status, w.created_at
FROM work_order w
INNER JOIN (
SELECT id FROM work_order
WHERE tenant_id = 1024 AND status = 3
ORDER BY created_at DESC
LIMIT 100000, 20
) t ON w.id = t.id;
还有一种情况是统计信息过期。表刚批量导入过数据,优化器还按旧的行数估算,明明有索引却选了全表扫。ANALYZE TABLE 跑一下,执行计划可能立刻变。这类问题在分区表上更常见,因为每个分区的统计是分开维护的。
那什么时候才算真的到了数据量的瓶颈。三个信号比较硬,写入开始排队、DDL 从秒级变成分钟级、备份恢复的时间影响到故障恢复目标。查询慢只要还能靠索引和写法解决,就说明结构没到非拆不可的地步。
二、三种方案,各自解决的是不同问题
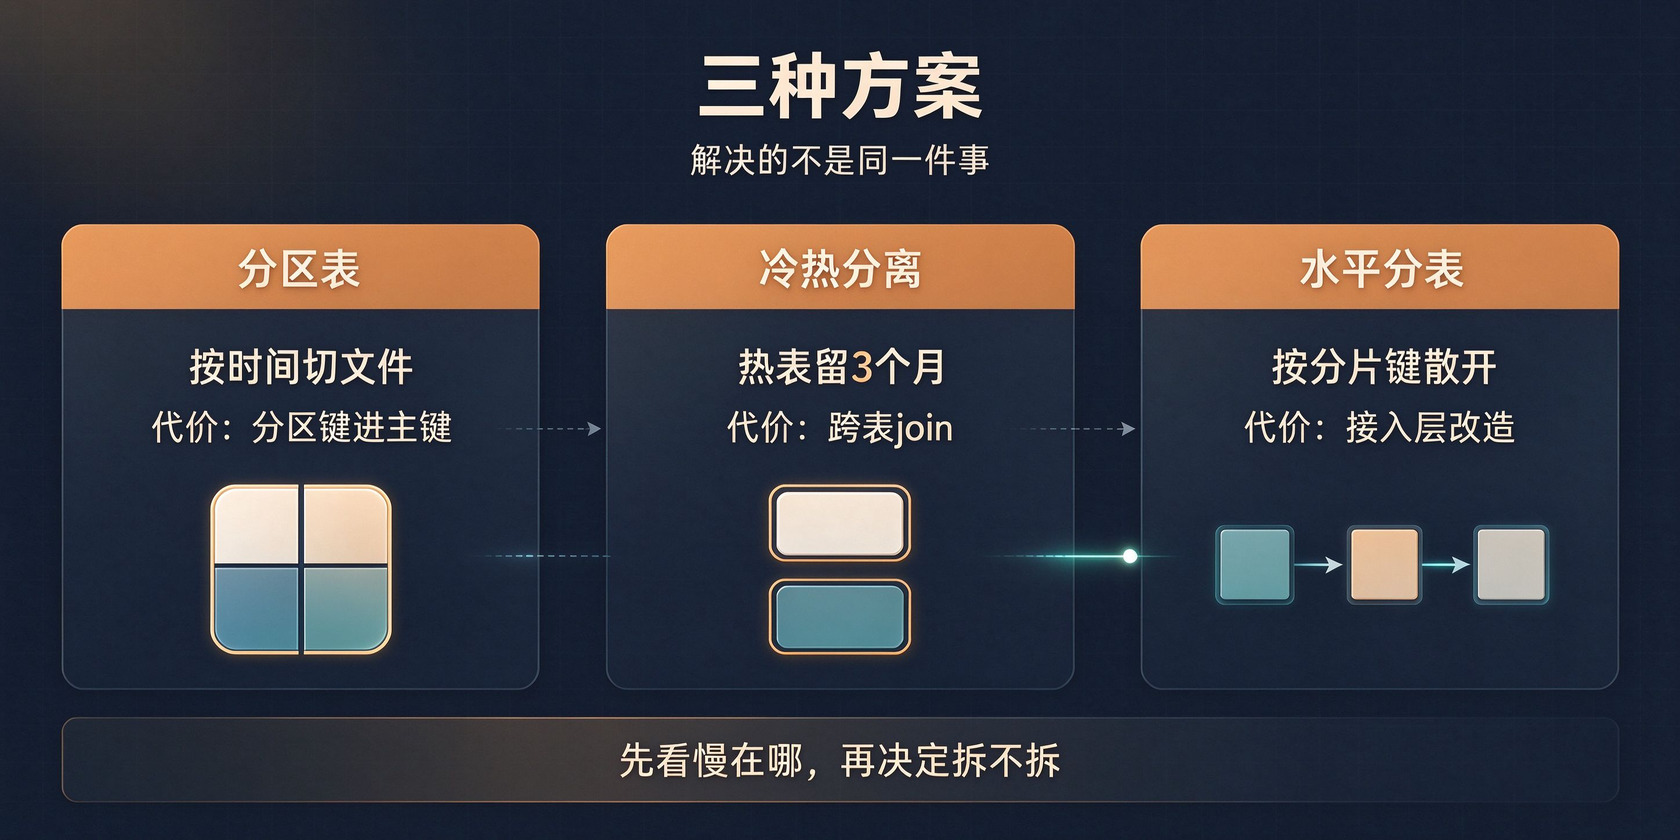
分区表在物理上把数据切成多个文件,逻辑上还是一张表。按月做 RANGE 分区,查询带上时间范围,优化器只扫对应分区,裁剪掉的部分连读都不读。它最擅长的是时间局部性强的业务,工单、日志、流水都合适。代价也很明确,分区键必须进主键和唯一键,跨分区查询会退化成扫全部分区,分区数量多了元数据开销和 DDL 时间都会上来。
冷热分离是另一种思路,把只查最近这件事变成架构约定。热表留最近三个月或半年,历史数据搬到结构相同的归档表,查询按时间条件路由到不同的表。它的好处是实现简单、对业务侵入小、归档表可以单独压缩或放到便宜的存储。麻烦在于跨表 join 和统计,历史详情页要查关联数据时,得靠冗余字段或者宽表顶上去。
水平分表解决的是写入和存储的横向扩展。数据按分片键散到多个库或表,单表行数控制在一千万以内,写入压力也分散了。它适合那种持续高速写入、查询又天然带分片键的业务,比如按租户拆的 SaaS、按用户拆的订单。代价全在接入层,路由规则、跨分片查询、分布式事务、扩容迁移,每一项都要额外的人力。
拿这三个维度去套,判断会快很多。数据增长慢、查询带时间范围,分区表够用。业务只关心最近一段、历史数据几乎不查,冷热分离最省事。写入已经是瓶颈、单表三年内必然破亿、查询还能找到稳定的分片键,才轮到分表。三个都不满足,先把索引、缓存、读写分离做完再说。
三、分区表和冷热分离,SQL 怎么写
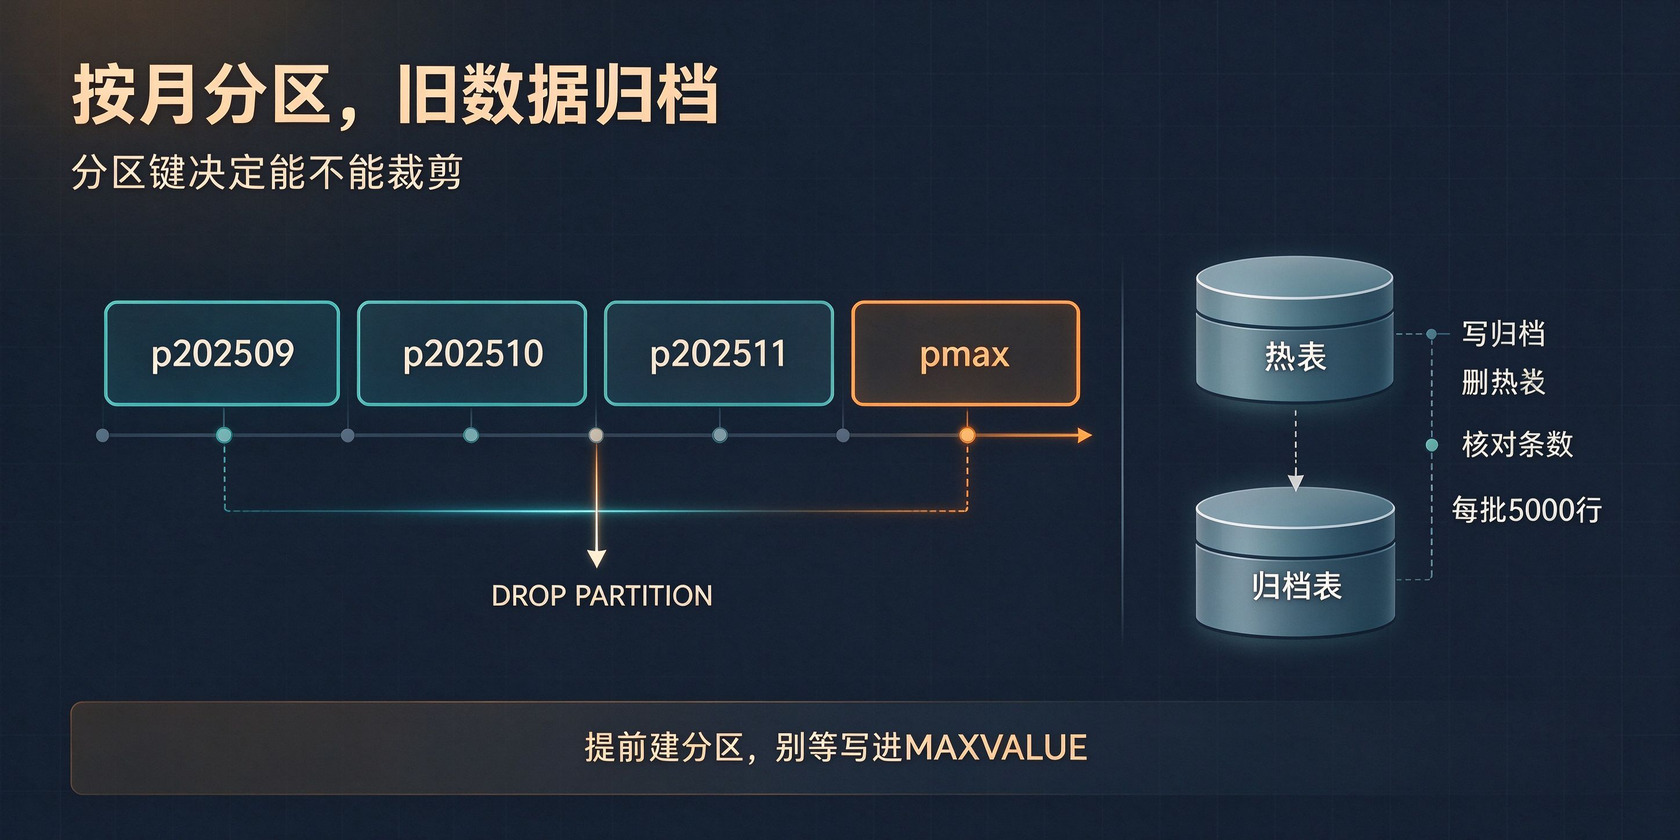
按月分区的建表语句大概是这样,主键必须带上 created_at,否则 MySQL 直接拒绝建表。
CREATE TABLE work_order (
id          BIGINT       NOT NULL,
tenant_id   INT          NOT NULL,
status      TINYINT      NOT NULL,
title       VARCHAR(200) NOT NULL,
created_at  DATETIME     NOT NULL,
PRIMARY KEY (id, created_at),
KEY idx_tenant_status (tenant_id, status, created_at)
) ENGINE=InnoDB
PARTITION BY RANGE COLUMNS(created_at) (
PARTITION p202509 VALUES LESS THAN ('2025-10-01'),
PARTITION p202510 VALUES LESS THAN ('2025-11-01'),
PARTITION p202511 VALUES LESS THAN ('2025-12-01'),
PARTITION pmax    VALUES LESS THAN (MAXVALUE)
);
索引在分区表里是本地索引,每个分区各建一份。查询能不能裁剪,全看 WHERE 里有没有分区键的常量或范围。带 created_at BETWEEN 的会只扫两三个分区,只按 tenant_id 和 status 过滤的会把所有分区扫一遍,这时候分区反而增加了开销。
维护上有个习惯要提前养成,分区要提前建。写个定时任务每月二十号建下个月的分区,别等到月底数据写进 MAXVALUE 再处理。归档旧数据用 DROP PARTITION,元数据操作,秒级完成,比 DELETE 几百万行快几个数量级,binlog 也不会爆。
ALTER TABLE work_order DROP PARTITION p202509;
注意 MAXVALUE 那个兜底分区,只要它还在,ADD PARTITION 就会报错。要加新分区得先 REORGANIZE pmax,把它拆成新分区和新的 pmax,这一步会重写数据,挑低峰期做。
冷热分离的落地更朴素一些。归档表结构和热表保持一致,多一个 archived_at 字段记录搬过来的时间。归档任务按主键区间分批跑,一批五千行,先写归档表、核对条数、再删热表,中间任何一步失败都能重跑。
INSERT INTO work_order_archive
SELECT *, NOW() FROM work_order
WHERE created_at < '2025-08-01' AND id BETWEEN 1000000 AND 1004999;
DELETE FROM work_order
WHERE id BETWEEN 1000000 AND 1004999
AND created_at < '2025-08-01';
批量大小要压住,五千行大约是几十毫秒到几百毫秒,事务短、锁的范围小,主从延迟也可控。一次搬五十万行看起来干脆,实际会把从库拖到几分钟延迟,业务侧读到的还是旧数据。
查询路由放在数据访问层做。请求里带时间范围,且结束时间早于热表边界,直接查归档表;跨边界的查两张表再合并;完全不带时间的,默认只查热表,同时在接口上把时间参数设成必填。这一条比技术方案本身更重要,因为大部分查不到历史数据的事故,根源是前端压根没传时间条件。
四、真要分表,分片键和扩容怎么定
分片键选错,后面全是补丁。SaaS 系统一般按 tenant_id 分,好处是同一个租户的数据落在一个分片,事务和查询都简单。问题是租户规模不均匀,一个上万人的客户就能把单个分片写到过热。常见的补法是给大租户单独分片,或者在 tenant_id 后面再拼一段哈希,把大租户的数据再散开。
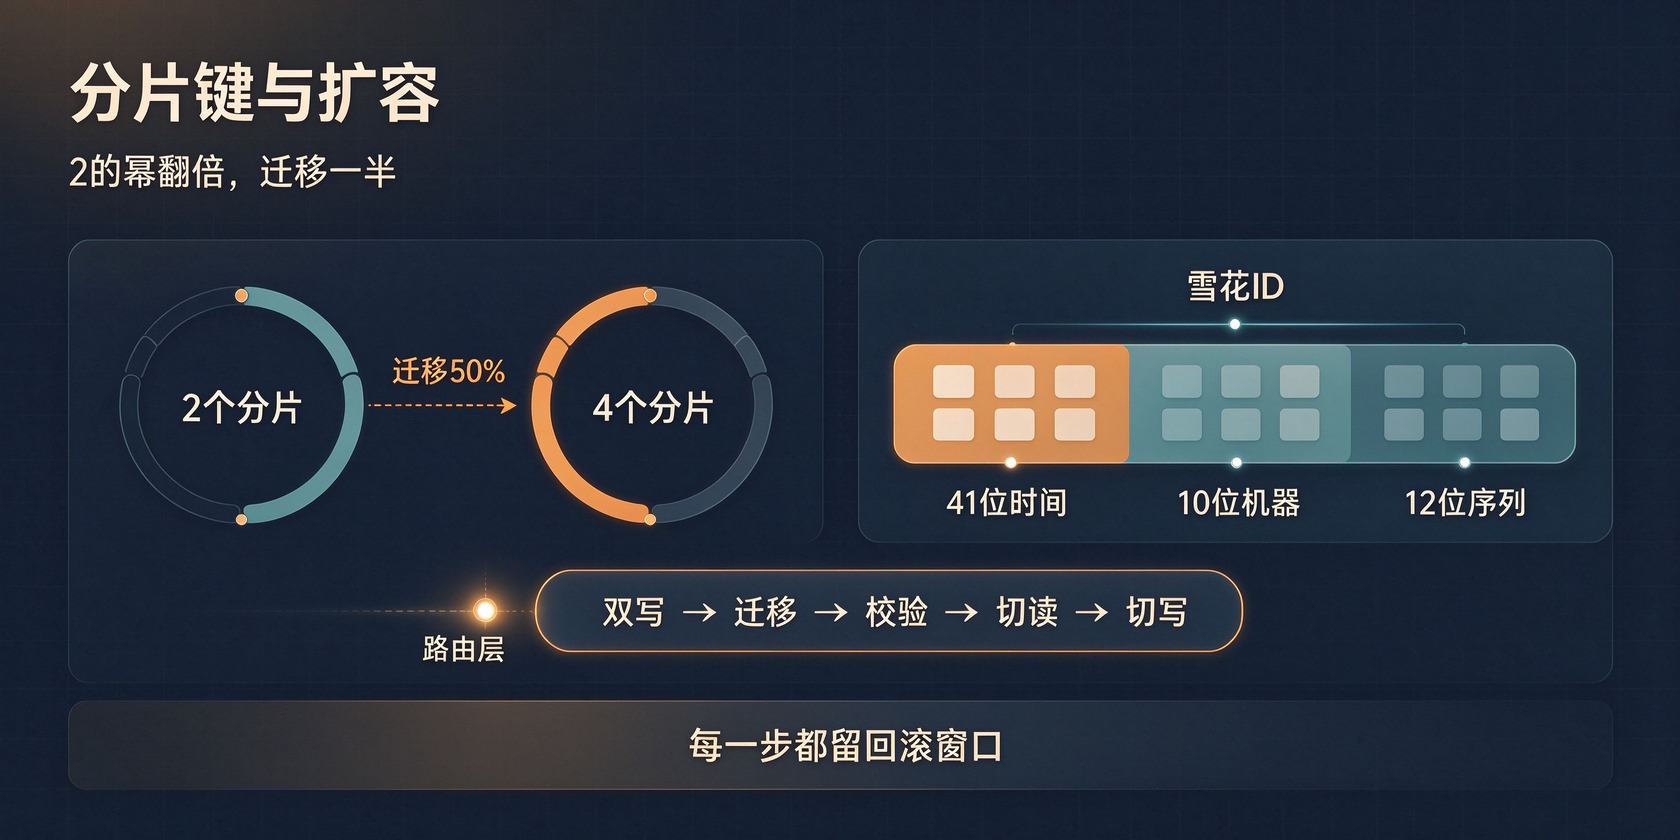
按 id 哈希分适合日志、流水这类没有天然归属的写多读少场景。分片数取 2 的幂,取模运算快,扩容时也好处理。2 个分片扩到 4 个,原来在 0 号分片的数据一半留在原地、一半搬到 2 号,1 号同理,迁移量正好是总量的一半,映射关系还能算出来。
分布式 ID 最好在分表之前就换掉。自增主键在多库下会冲突,等到分表再改,历史数据的 ID 迁移能把人拖死。雪花 ID 是 41 位时间戳加 10 位机器号加 12 位序列,单机每毫秒四千个,够用很多年。要注意机器号不能重复,容器环境里别用 IP 末段,重启后可能变;时钟回拨要直接抛异常,不能硬等。
路由放在哪一层,取决于团队规模。应用层自己封一个分片上下文,按分片键算表名或库名,实现简单、排查方便,缺点是跨分片的能力要自己补。用 ShardingSphere 这类中间件,路由和归并是现成的,代价是多一层代理、多一份运维,SQL 兼容性也要提前验。
跨分片查询没法绕。运营后台按状态查全量订单,这种需求在分表之后基本都要靠 ES 或者定时同步的宽表来接,别指望数据库归并。分页也一样,每个分片各取一页再合并,翻到后面越来越慢,改成游标分页就简单了,每次带上上一页的最大 id。
SELECT id, order_no, amount, created_at
FROM order_2025
WHERE tenant_id = 1024 AND id > 88231007
ORDER BY id ASC
LIMIT 20;
扩容是分表方案里最容易被低估的部分。稳妥的顺序是双写、全量迁移、数据校验、切读、切写、下线旧表,每一步都留可回滚的窗口。校验不能只对总数,要抽样比对金额、状态这类关键字段,总数对上但内容错的例子并不少见。
回到开头那个库。补完索引之后,工单表的写入还在涨,按现在的速度三年后会到六千万行,那时候再考虑按月分区,把三年前的数据归档出去。分表暂时不需要,因为查询永远带时间范围,也没有跨租户的聚合需求。
拆表这件事,先量慢在哪,再决定拆不拆。真要拆,先想清楚三件事,数据按什么键散、跨分片的查询谁来接、扩的时候怎么搬。这三件事没答案,分表只是把一个问题变成三个。


 在线
 电话
 微信
 需求
 TOP

