去年双十一,一个做本地生活团购的客户,上午十点开抢。九点五十九分,后台一切正常,运营还在群里发倒数。十点整,下单按钮点下去开始转圈。十点零二分,客服群刷屏了,有人付了钱订单没生成,有人库存显示还有但下不了单。十点零五分,技术负责人被拉进群,老板第一句话是,是不是服务器不够,赶紧加几台。
这句话问得很自然,但方向偏了。那台服务器当天的 CPU 只跑到三成,内存还剩一半,磁盘也没打满。真正卡住的地方在数据库和支付回调上,加机器解决不了。
一、活动流量不是多了一点,是几分钟内多出十几倍
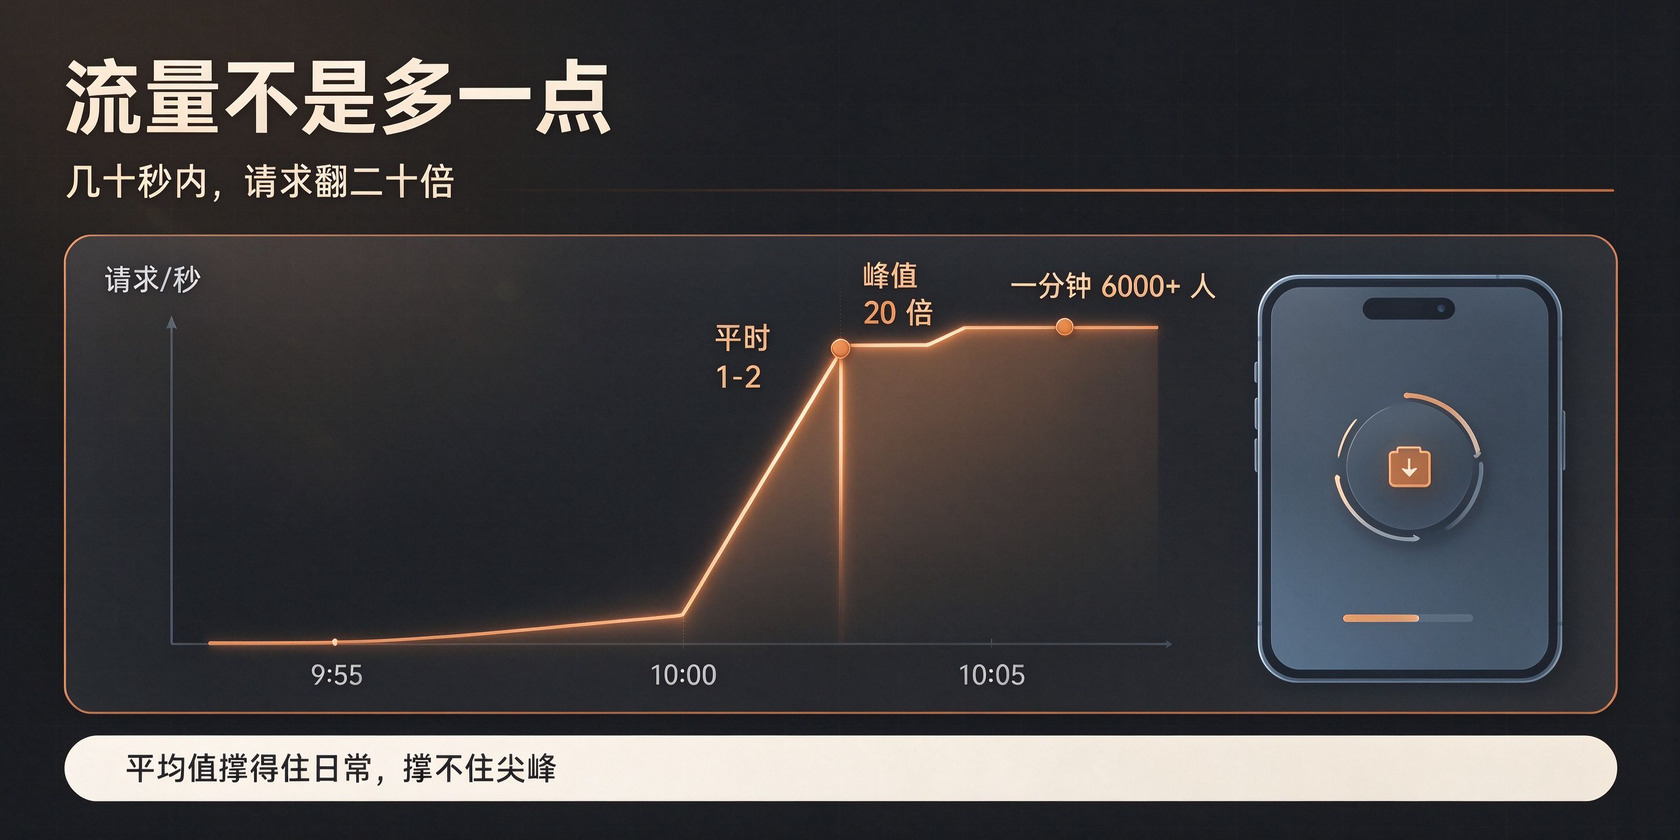
这个平台平时一天的订单两千单上下,摊在十几个小时里,每秒也就一两个请求。活动那天,十点整那一分钟涌进来六千多人,每秒请求量直接冲到平时的二十倍。这个倍数不是慢慢涨上去的,是在几十秒内跳上去的,前面一点缓冲都没有。
系统的很多设计都是按平均值做的。连接池按平时的并发配,缓存按平时的命中率设,带宽按平时的峰值买。平均值能扛住,不代表尖峰能扛住。一条双向四车道的高速,平时跑得顺畅,节假日免费那一个小时,路口能堵出五公里。
更麻烦的是,尖峰来的时候用户的行为也会变形。平时一个人下单要来回看三遍详情页,活动时直接点立即购买,路径短了,请求更集中。还有人同时开两台手机抢,有人写脚本刷,有人不停刷新库存页面。这些动作在设计阶段基本没人算进去。
还有一个常被忽略的点,是活动开始前的推送。运营在九点五十五分给八万会员群发了一条模板消息,大家在差不多同一分钟点进来,等于人为制造了一个入口尖峰。推送时间要错开,分批发,间隔几分钟,成本几乎为零,效果差别很大。
二、最先倒下的往往不是服务器,是数据库
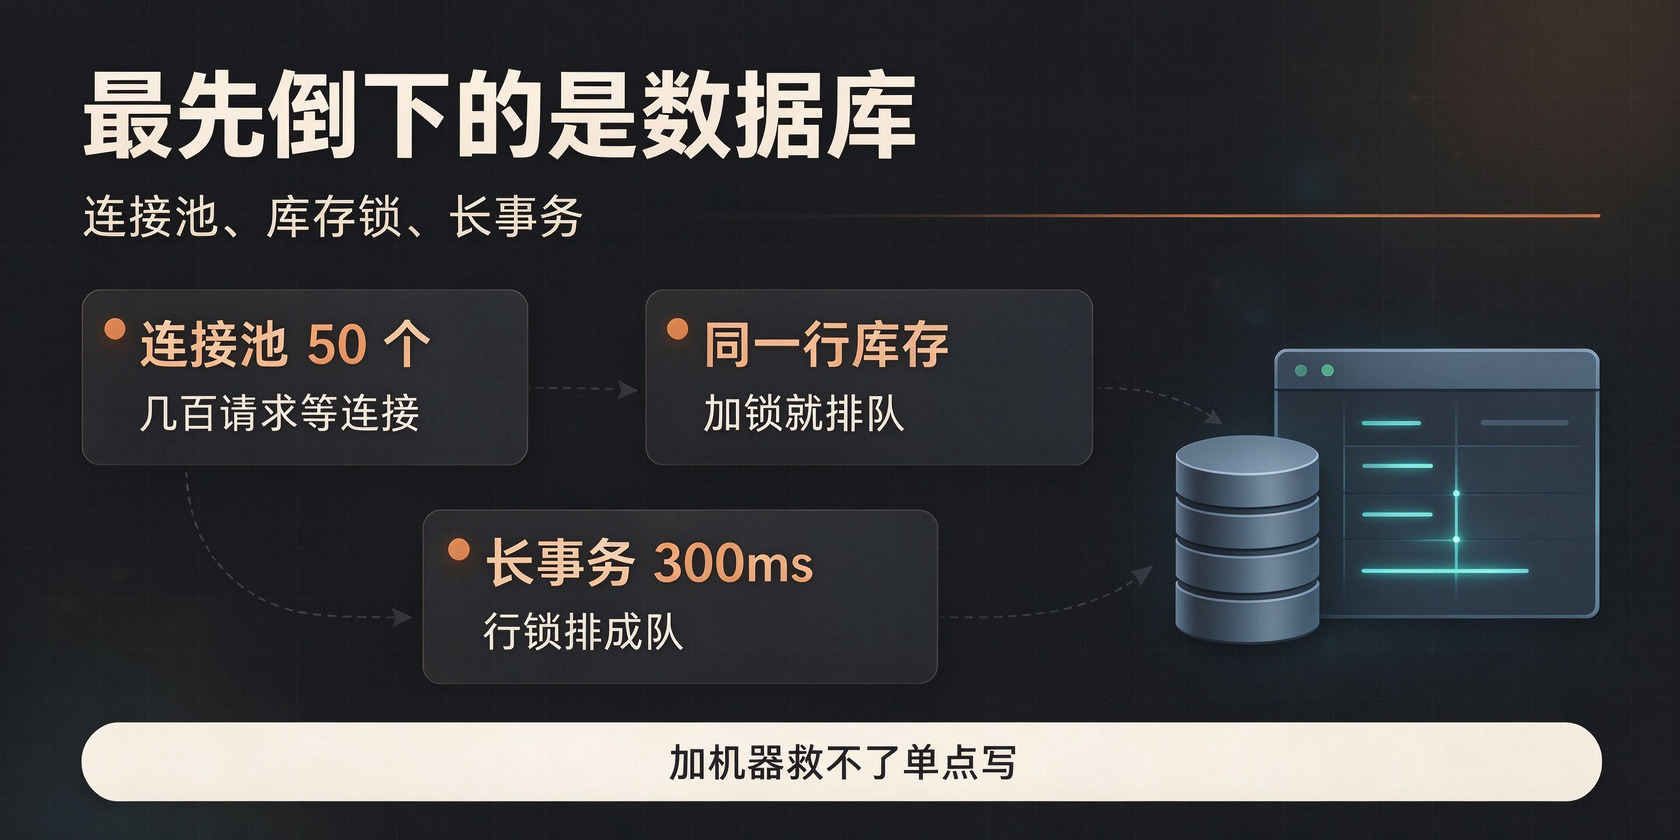
加机器这件事,对 CPU 密集的服务有用,对数据库基本没用。数据库是有状态的单点,加机器只能加只读副本,写还得回主库。抢购恰好全是写操作,下单、扣库存、生成订单、记流水,每一样都要落库。
库存扣减是最容易出事的。两个人同时买最后一件,都读到库存是一,都判断可以买,都写回零。结果卖了两件。反过来加锁,锁的范围一大,几百个请求排队等同一把锁,响应时间从几十毫秒涨到几秒,前端超时,用户重复提交,又变成新的压力。锁加得不对,超卖变成少卖,用户付了钱没货。
连接池是个隐形炸弹。平时配五十个连接够用,活动时几百个请求同时进来,后面的全在等连接。等不到就超时,超时后前端重试,重试又占一个新连接。一个原本三秒能结束的请求,被拖成三十秒,最后把连接池彻底占满。这种雪崩不是慢慢发生的,是几十秒内连锁完成的。
还有事务。一个下单事务里如果套了远程调用,比如同步去调积分服务、调短信服务,这个事务的持有时间就不是几毫秒,可能是几百毫秒。活动期间这种长事务一多,主库的行锁排成队,整张订单表都被拖住。
平时不太显眼的慢查询,活动时会集中暴露。一条平时走索引只要二三十毫秒的统计 SQL,在数据量涨上来、并发一多之后,可能变成全表扫描,一条语句就占住几秒。几十条这样的语句叠在一起,数据库连接被慢慢吃光。上线前把核心链路的执行计划过一遍,比事后补索引有用。
三、限流、排队、降级,都是在决定谁能进来
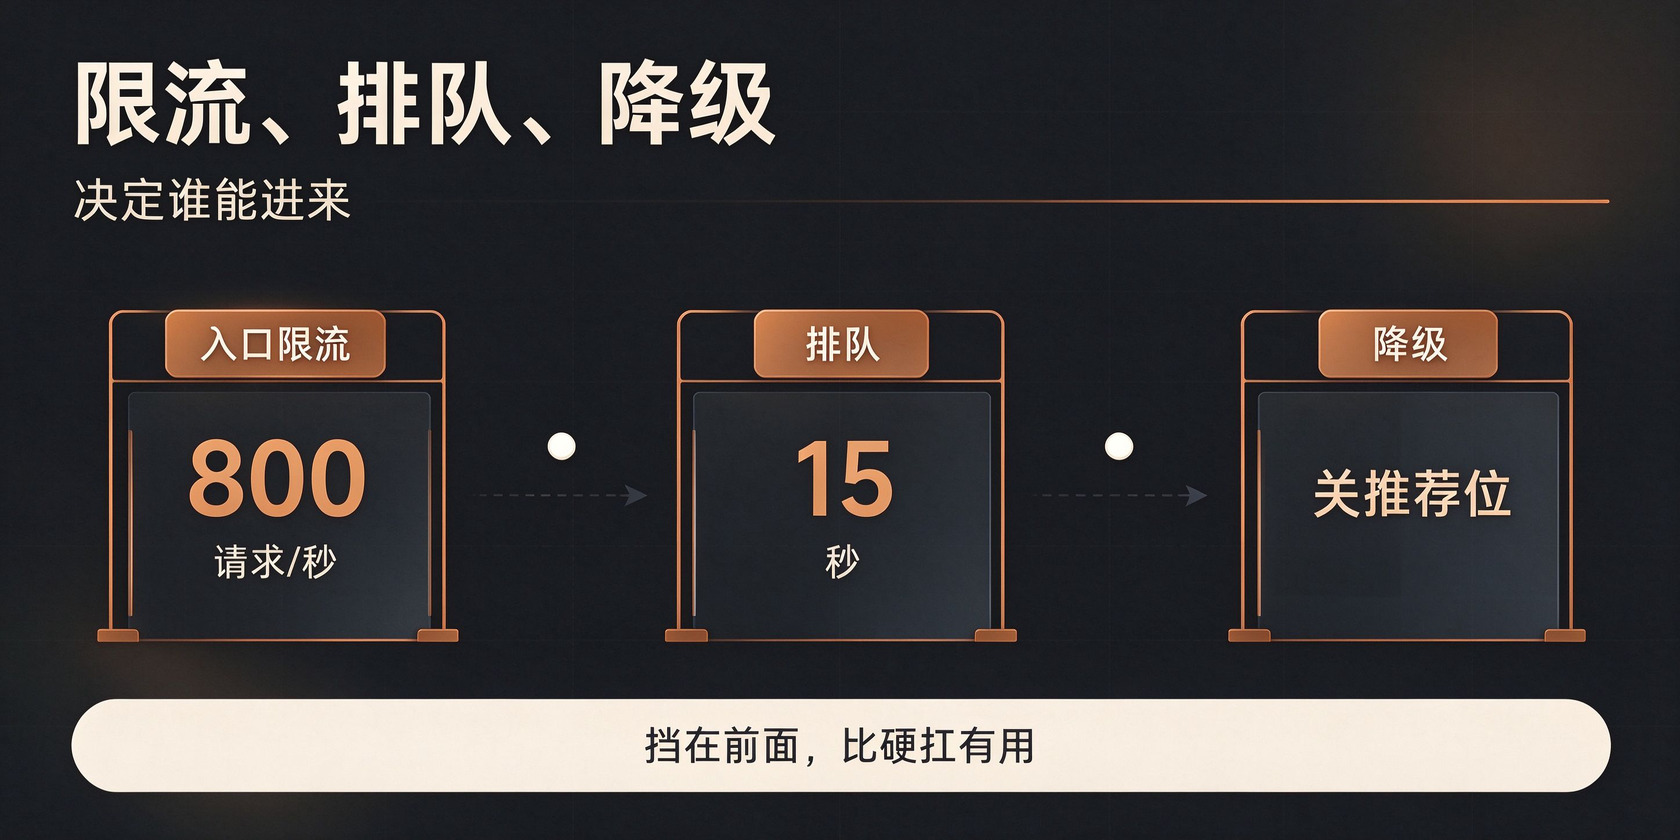
系统再强也有上限,超过上限就得决定让谁进来、让谁等、让谁直接拒绝。这个决定要在活动前做完,不能等崩了再做。挡在前面,比在后面硬扛有用得多。
最常见的是入口限流。按用户维度限,一个账号一秒最多三次请求。按接口维度限,下单接口每秒放进来八百个,多的直接返回稍后再试。按 IP 限,防脚本刷。限流的数字不是拍脑袋,是压测出来的,压到系统还能稳定处理的那个量。
接下来是排队。请求进来不直接打数据库,先进队列,按库存能承受的速度一个个消费。用户看到的是正在为你排队、预计等待十五秒,而不是一个永远转圈的按钮。排队至少给了系统一个可控的节奏,也给了用户一个明确的预期。
降级也得上。活动期间把不重要的功能关掉,商品详情页的推荐位不查了,评价列表改成读缓存,积分翻倍展示先挂个静态图,把资源全部让给下单这条主链路。降级方案要提前写好开关,活动时一键切换,不能现场改代码。
还有缓存。活动页面能被静态化的全部静态化,能上 CDN 的全上 CDN。库存这种高频变动的数据不能全靠缓存,但商品信息、活动规则、页面装修这些完全可以。缓存没做好,所有请求都落到数据库,前面那些问题会提前爆发。
库存还有个容易被忽略的细节,是热点行。一场活动主推一个九块九的商品,所有请求都在抢同一行库存记录,数据库层面再怎么优化,这一行也是串行的。常见的做法是把库存拆成若干段,请求分散到不同段上扣,最后再汇总,压力能摊开好几倍。
四、活动前要算的那笔账,比技术方案更重要
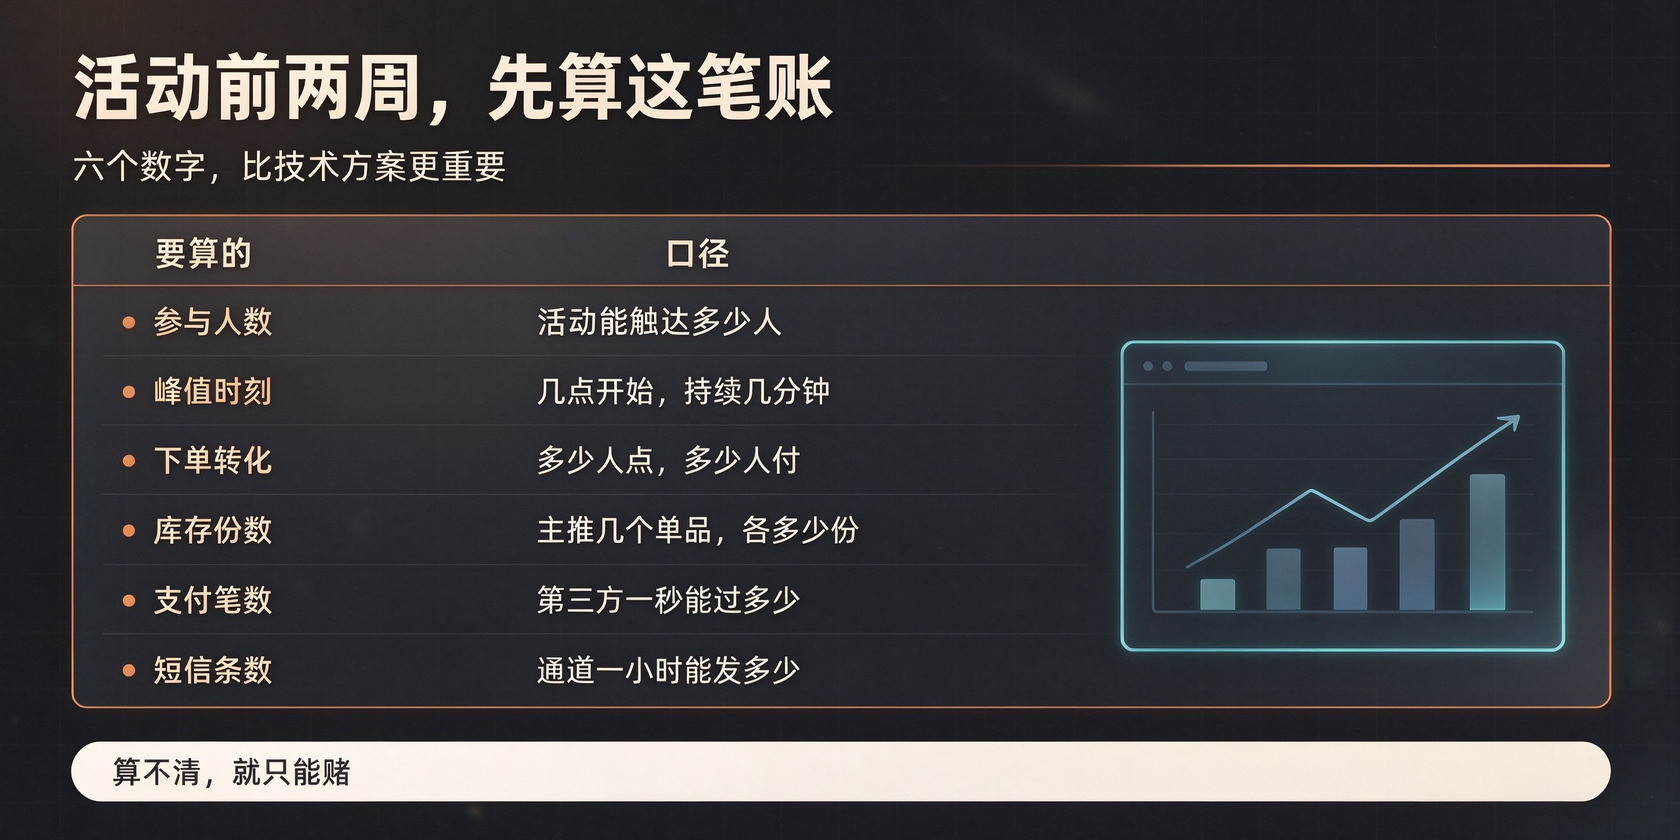
真正让活动不出事的,是活动前两周那张表。临场反应救不了。表上要写清楚,预计多少人参与,峰值大概在几点,每个用户平均点几次,下单转化率多少,库存多少份,支付接口每秒能处理多少笔,短信通道一秒能发几条。这些数字算出来,才知道要准备多少资源。
第三方接口最容易被忽略。微信支付、支付宝、短信服务商、电子发票,这些都不由你控制。它们各有各的限流,支付接口一秒超过多少笔就排队,短信通道一小时超过多少条就延迟。活动当天自己的系统扛住了,支付回调晚了十分钟,订单还是卡在待支付。
压测也要真做。不是本地点几下按钮,是拿接近真实的流量打一遍,看数据库的 CPU、连接数、慢查询、队列堆积。压测里暴露的问题,改起来的成本大概是活动当天发现的三分之一。压完还要留余量,真实流量总比预估的更野。
带宽和图片也得算。活动页面如果放十几张高清图,几千人同时打开,带宽瞬间打满,页面加载要十几秒,用户早走了。图片压缩、懒加载、CDN,这些平时不起眼的细节,活动时会一起找你算账。
活动当天还得有人盯着。盯的不是服务器指示灯,是几个具体指标,下单成功率、支付回调延迟、接口平均响应时间、队列积压长度。哪一项开始往下掉,就按提前写好的预案切换,别等到用户投诉才反应。回滚方案也要备好,新功能出问题能十分钟退回去,比现场翻代码强。
总结
同一套系统,平时跑得好好的,一到活动就崩,多数时候跟开发水平关系不大。是从设计的第一天起,就没人按最坏的那一分钟算过。平均值能撑住日常,撑不住尖峰。这个账也没法只压在技术身上,运营要出活动节奏,老板要出预算,开发要出容量方案,三方坐到一起才能算明白。
找开发公司做活动类系统,可以问三个具体问题。峰值大概多少,压测做过没有,限流和降级方案在哪。能拿出文档和数据的,通常心里有底。只会说没问题的,多半是没算过。


 在线
 电话
 微信
 需求
 TOP

