很多项目现在是这么干的。设计用 AI 出三张产品主图,运营用 AI 写五条详情页文案,开发用 AI 补一段接口代码。图发到官网,文案上了店铺,代码跟着版本交付。等到客户问一句,这些东西版权归谁,能不能商用,被别人搬走怎么办,现场往往没人能答完整。
大家习惯把 AI 当成一个作者。著作权法里能当作者的只有自然人、法人或者非法人组织,模型本身不行。AI 出图、出文案、出代码,最终还是要看人在里面做了什么。版权就是著作权,下面两个词混着用。先把归属、训练数据、合同、分类这四件事捋一遍,再谈怎么用,边界得自己定,不能等出了事再补。
一、AI 生成物不一定有版权,先看人的贡献
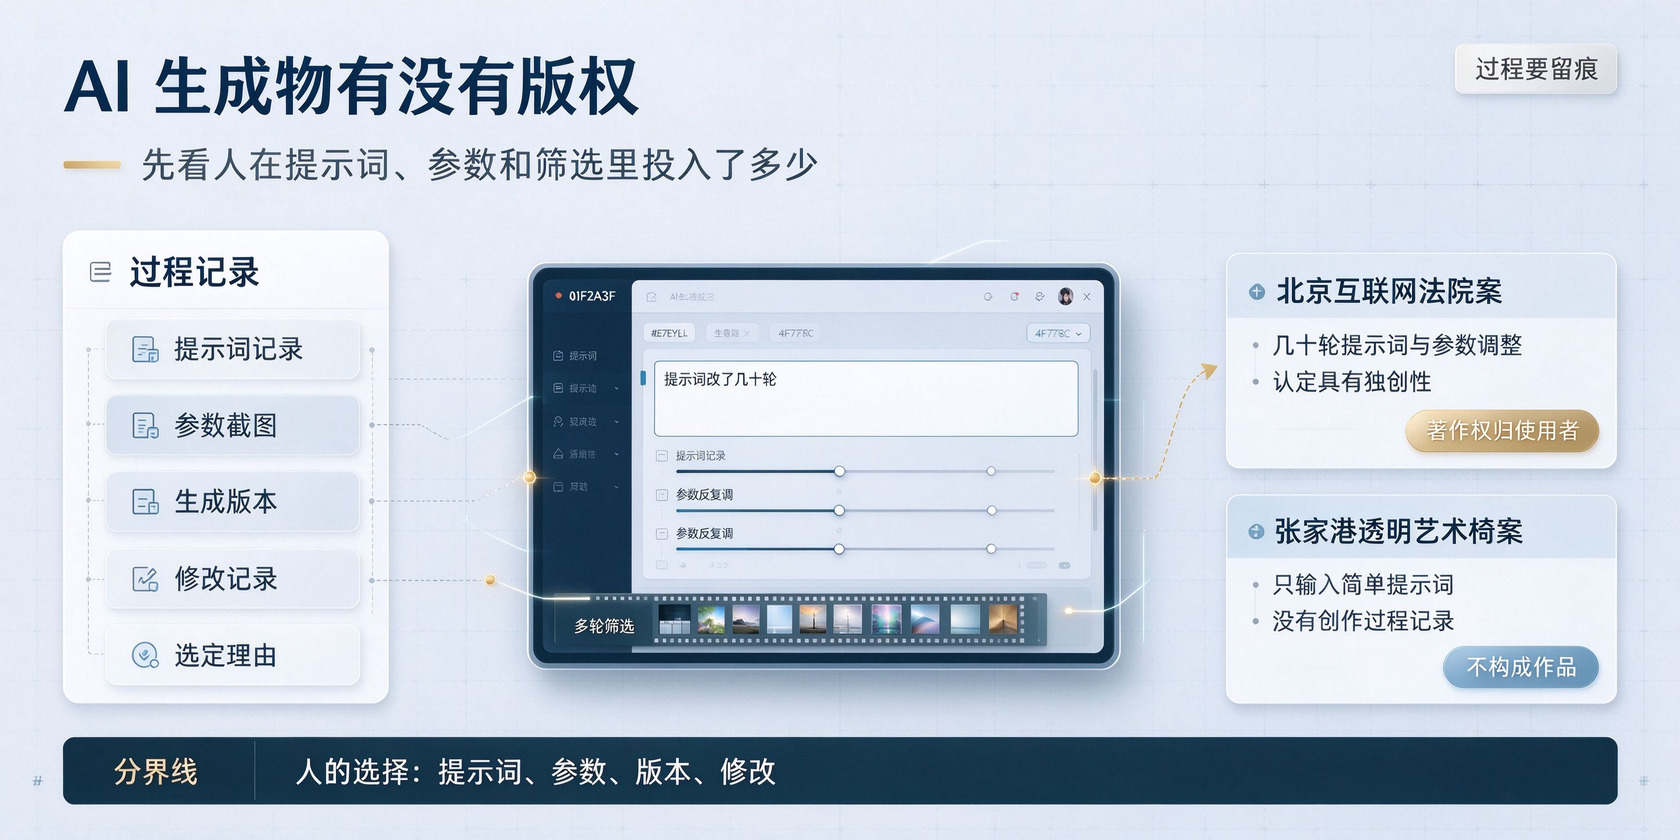
北京互联网法院判过一个 AI 出图的案子。原告用 Stable Diffusion 生成古风人物图,提示词改了几十轮,参数也反复调,最终选定一张发到小红书。图被别的账号拿去配文,还抹了署名水印,法院认定这张图有独创性,原告享有著作权。
另一个案子走向相反。张家港市人民法院审的「幻之翼透明艺术椅」,原告只输入了简单提示词,拿不出完整的创作过程记录。法院认为提示词停留在思想层面,生成结果没有体现足够的人类智力投入,没把那张图认定为作品。
两个案子放在一起看,分界线不在用没用 AI,在人做了多少选择。提示词怎么设计,参数怎么调,生成了几版,为什么选这一版,后面有没有再改,这些动作能不能留下记录,直接影响法院怎么看。
只写一句「帮我画一张科技感海报」,然后从结果里挑一张,风险很高。反过来,先定构图、色调、主体、文字位置,再反复改,再人工修图,人的贡献更容易被看见。改了什么、改到什么程度,最好有分层文件或者版本记录。
代码也按这个逻辑看。AI 吐出来的代码不自动带著作权,人在需求拆解、结构设计、关键逻辑修改、测试验收里做了多少,才是重点。文案更吃人的判断,一句广告语可能因为太短,达不到独创性门槛,一篇有自己结构、案例和观点的长文,情况会不一样。
不管有没有版权,过程记录都要留。提示词、参数截图、生成版本、修改记录、最终选定理由,能存就存,法院看证据,不听口头解释。如果生成物没有被认定为作品,合同还可以约定保密和使用限制,商标、商业秘密、反不正当竞争也能用,只是路径不同。
二、训练数据来源不清,商用风险谁承担
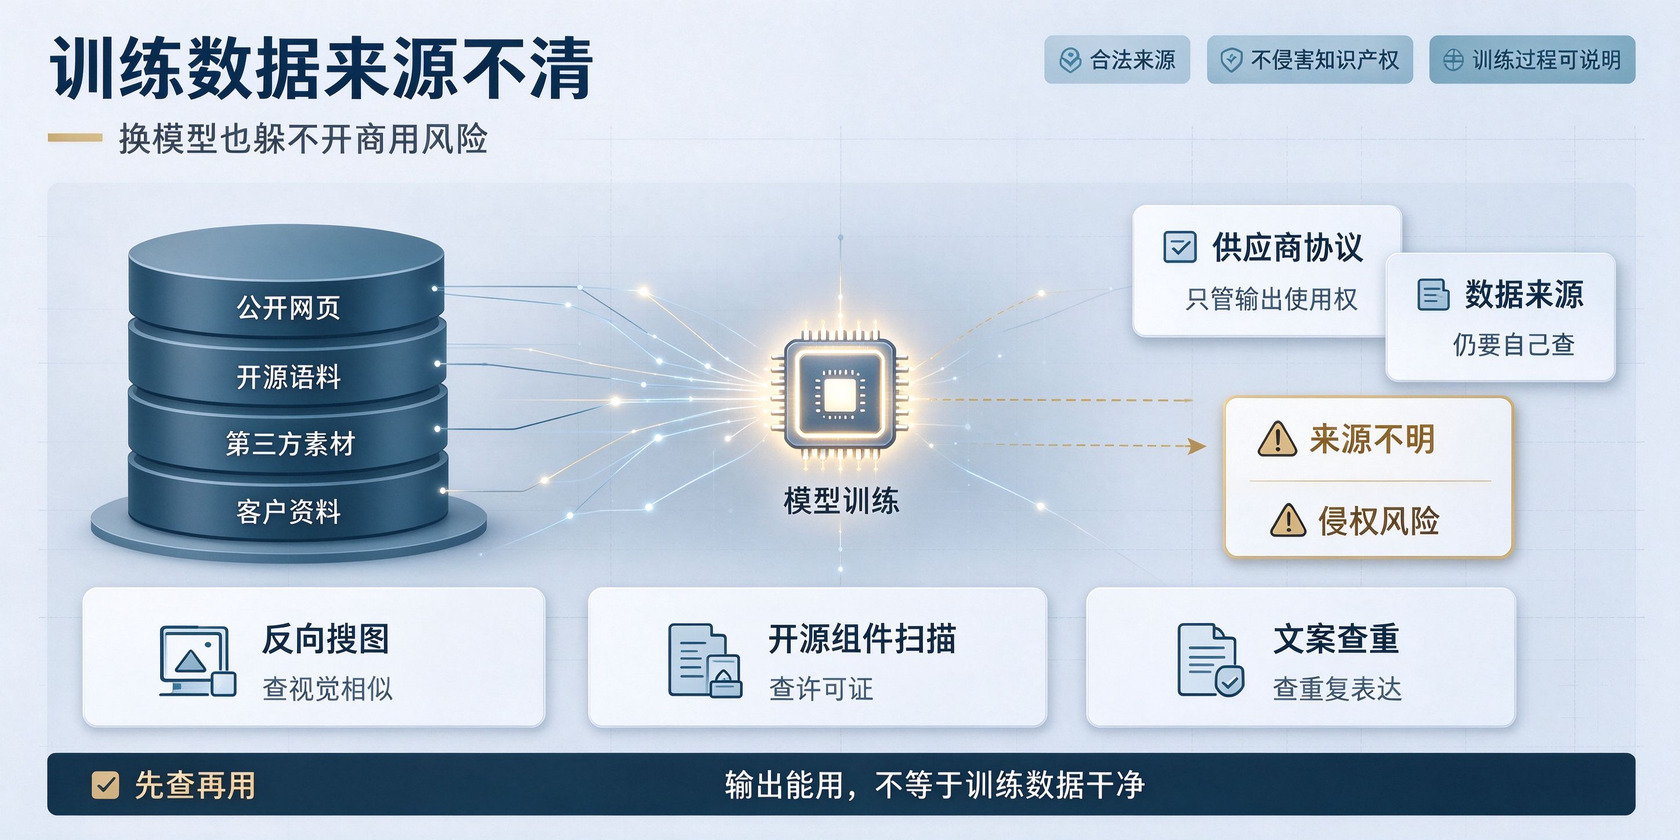
企业多数时候不自己训练模型,直接用第三方工具。工具的用户协议常写「输出内容归用户使用」,很多人看到这句就放心了。这句话解决的是输出使用权,解决不了训练数据来源。
《生成式人工智能服务管理暂行办法》要求提供者使用具有合法来源的数据和基础模型,涉及知识产权不得侵权。2026 年 9 月最高人民法院发布的《关于依法审理涉人工智能纠纷案件的意见》又往前走了一步,开发者提出不侵权抗辩,要提供训练数据来源、训练过程记录、模型运行模式这些材料。
这条对企业的现实影响是,供应商说自己合规,不能只看一句承诺。要让对方拿出训练数据来源说明、模型版本、知识产权赔偿条款,拿不出来,风险就还在。使用者也不是完全没事,知道或者应当知道在先作品存在,还用 AI 生成实质相似的内容,又没有合理抗辩,权利人可以要求使用者担责。
商用前做一次相似性检查很有必要。图片拿去做反向搜图,看有没有撞上已有插画、角色、品牌视觉。代码跑一遍开源组件扫描,看有没有 GPL、AGPL 这类带传染性的许可证。文案查重,查事实,查有没有把别人的案例和数据搬过来。提示词里也别放客户未公开的产品图、合同截图、源代码和个人信息。
供应商的赔偿条款要读细。很多条款只赔第三方提出的知识产权索赔,前提是用户没有违反使用限制,没有把输出拿去改造成侵权内容,通知也要及时。真出事,流程和赔偿上限都可能卡住。
模型开源不等于训练数据干净。开源许可证管的是代码、权重这些对象,训练语料是不是合法拿到,是另一件事。采购时把这两件事分开问,别被「开源」两个字带过去。用境外模型时,数据出境和跨境访问也要先看一遍。
三、合同里写清输出归属和侵权赔付
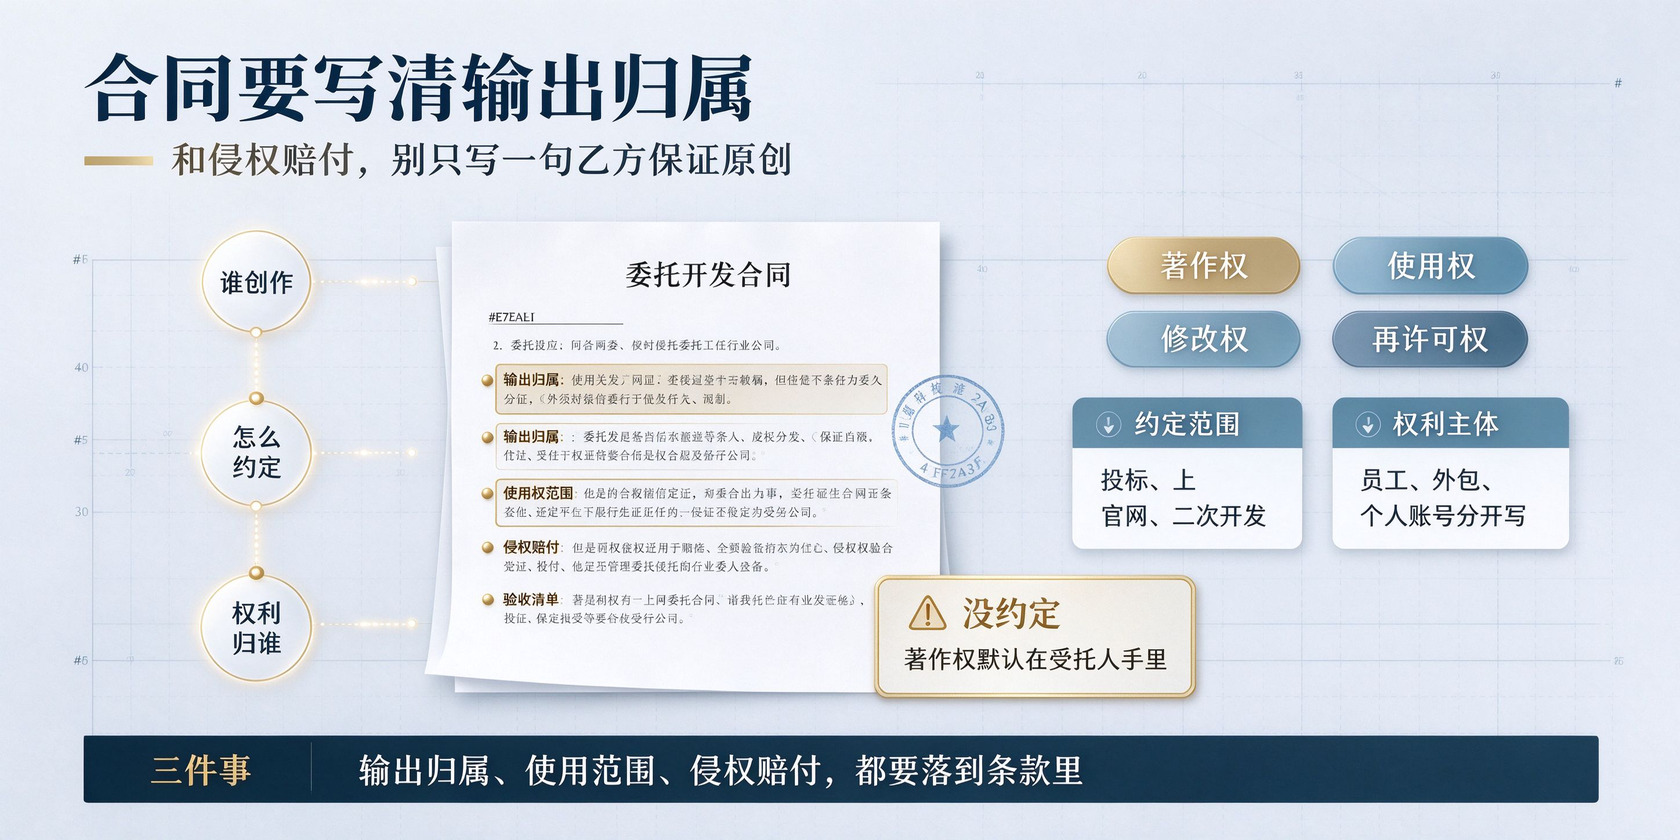
合同里最先要写的是输出归谁。很多甲方以为付了钱,版权自然归自己。著作权法和计算机软件保护条例都规定,委托创作或者委托开发的著作权归属由合同约定,合同没写清楚,默认往往在受托人手里。
所以合同别只写「交付成果」。要写清图片、文案、代码、文档、源文件、设计稿各自归谁,著作权、使用权、修改权、再许可权怎么分。甲方要拿去投标、上官网、做二次开发,这些用途要提前写进去。
员工用 AI 也要有制度。员工在职期间按工作任务开发的软件,通常由公司享有软件著作权,但劳动合同、项目合同和内部制度要能对上。员工用个人账号生成的内容,账号里的使用条款可能和公司无关,这一点要提前说清。
侵权赔付条款要单独写,不要塞进一句「乙方保证原创」。要写谁负责抗辩,谁承担赔偿,赔偿有没有上限,客户修改或者组合使用后责任怎么分,第三方找上门时多久通知,是否需要配合删除和替换。
验收清单也要跟着改。除了功能、尺寸、文件格式,还要收 AI 工具清单、模型版本、提示词记录、人工修改记录、开源组件清单、第三方素材授权、相似性检查结果。清单不全,后面很难证明自己做过合规动作。
合同里不要轻易写「完全自主知识产权」或者「保证不侵权」。AI 参与的程度、训练数据、开源组件、第三方素材,任何一项没查清,这句话都可能变成把责任全揽到自己身上。外包项目尤其容易漏,开发把 AI 生成的代码和图片混在交付包里,甲方只验收功能,不问来源,等拿去申请软著、投标或者二次开发,才发现权利链不完整。
四、代码、图片、文案分开看,别一套条款打天下
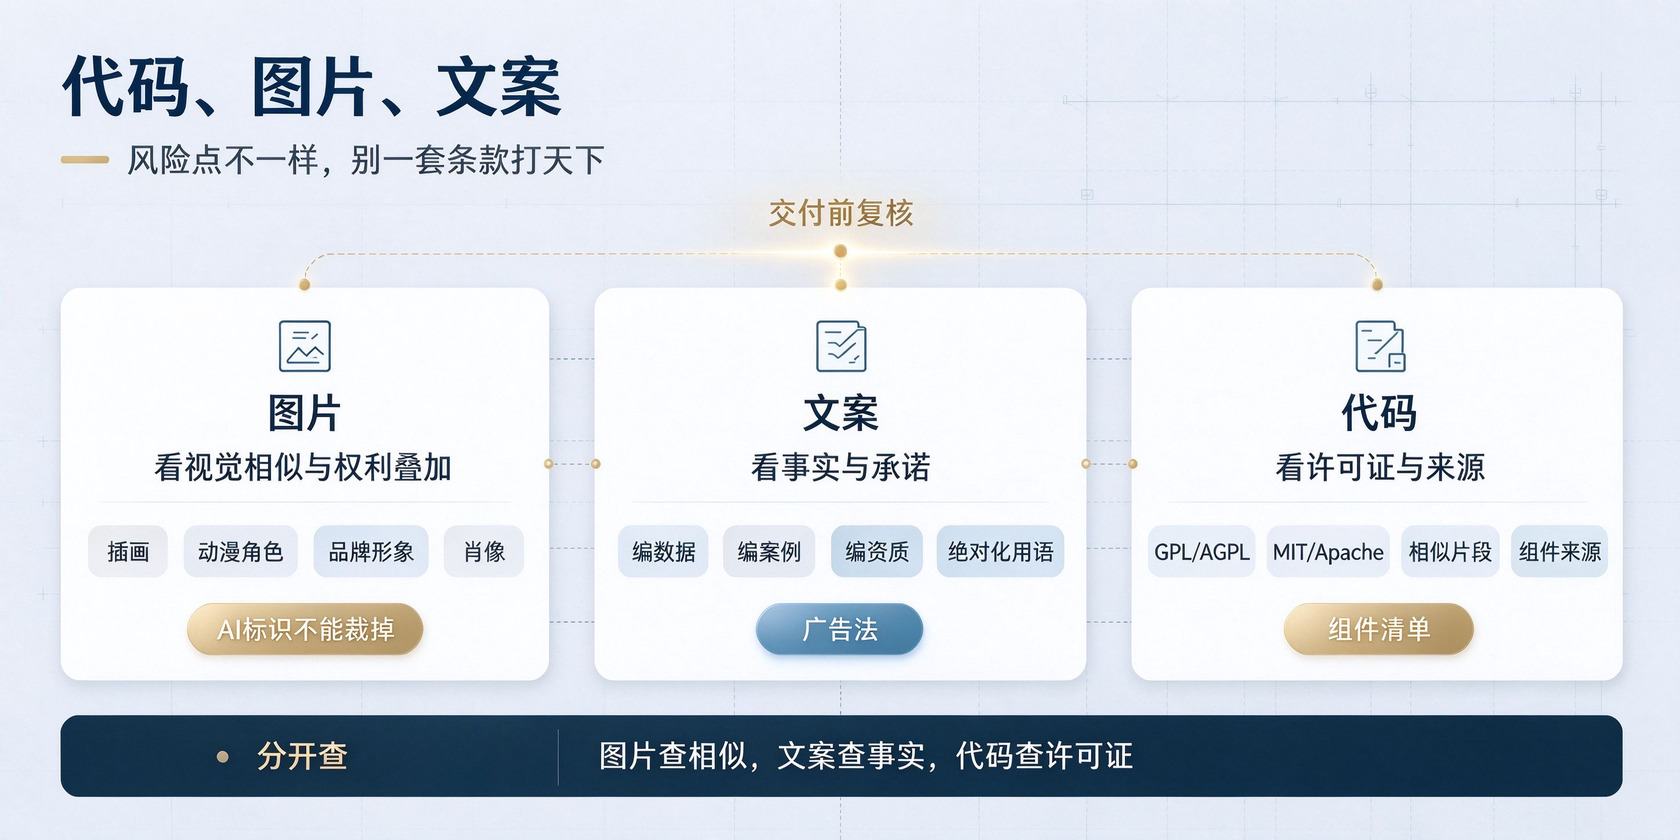
图片的风险在视觉相似和权利叠加。AI 生成图可能撞上已有插画、动漫角色、品牌形象,也可能用了某人的肖像。风格本身通常不受著作权保护,但具体角色、画面细节、品牌标识可能受保护。商用前做反向搜图,涉及人物要拿肖像授权。
现在发布 AI 生成图片、视频、文案,还要看《人工智能生成合成内容标识办法》。2025 年 9 月 1 日起施行,平台加的标识,别为了好看裁掉。该标 AI 生成的地方,标清楚,别让用户误以为是实拍或者真人写的。
文案的风险在事实和承诺。AI 会编数据、编案例、编资质,也会写出「全网第一」「百分百有效」这类广告法不喜欢的词。文案里的数字、案例、效果、认证,要逐条核实,别因为初稿是 AI 写的就跳过审核。
代码的风险在许可证和来源。Copilot、Cursor 这类工具补出来的代码,可能和训练语料里的代码高度相似。项目里混进 GPL、AGPL 组件,交付时可能被要求开放源代码。MIT、Apache 也不是随便用,署名和声明要保留。
三类东西不要用一套条款。图片这张清单最长,著作权、肖像、商标、标识都要看。文案的重点是事实、广告合规和查重。代码还要多一层开源许可证、第三方组件和交付源码范围。采购、外包、员工使用,三张清单分开做。
公司内部还需要一张 AI 使用清单。哪些工具能用,哪些数据不能往提示词里放,什么内容必须人工复核,生成记录存多久,谁负责验收。个人账号和企业账号也要分开,免费版工具的使用条款可能只覆盖个人使用,企业商用不一定被允许。
交付前,别把 AI 生成的内容直接当终稿。图片要看结构、文字、手部、品牌标识有没有错。文案要看事实和语气。代码要跑测试、做安全扫描。AI 只负责出初稿,责任还在人这边,禁掉 AI 不现实,边界写清楚更现实。


 在线
 电话
 微信
 需求
 TOP

