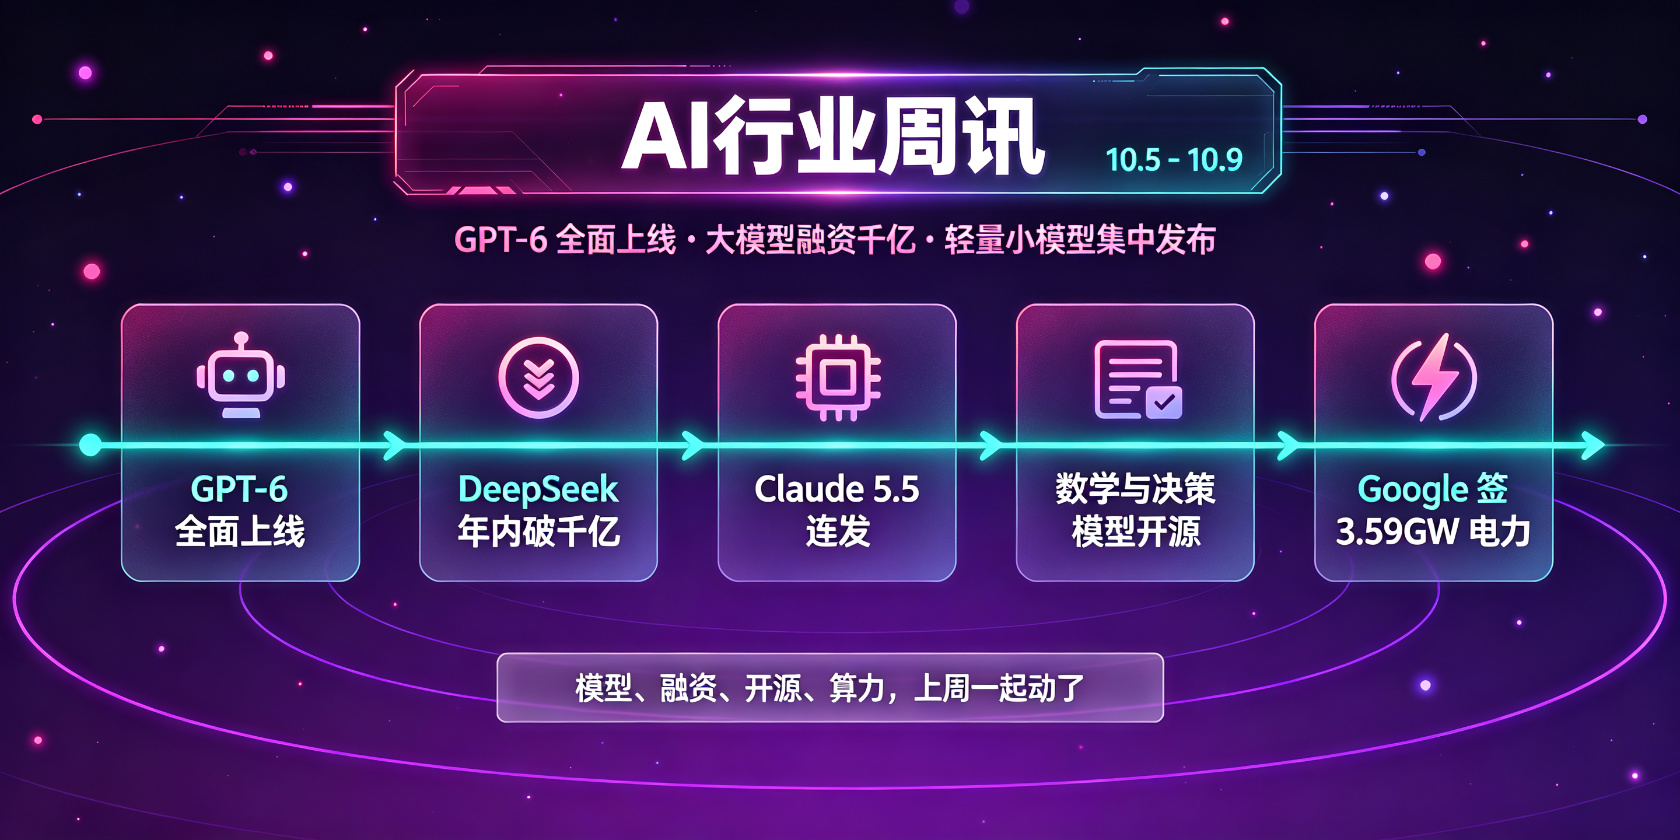
上周五,你打开 ChatGPT 的网页版,模型列表里多了个 GPT-6,点开就能用,免费和付费用户都有份。没有发布会,没有预热,就这么上了。
过去这一周 AI 圈的动静,比大多数人以为的大。我们把几件绕不开的事捋一遍,顺带说说每件事跟做应用、做软件的人到底有什么关系。
GPT-6 全面上线,竞赛进入 "赚钱能力" 大考
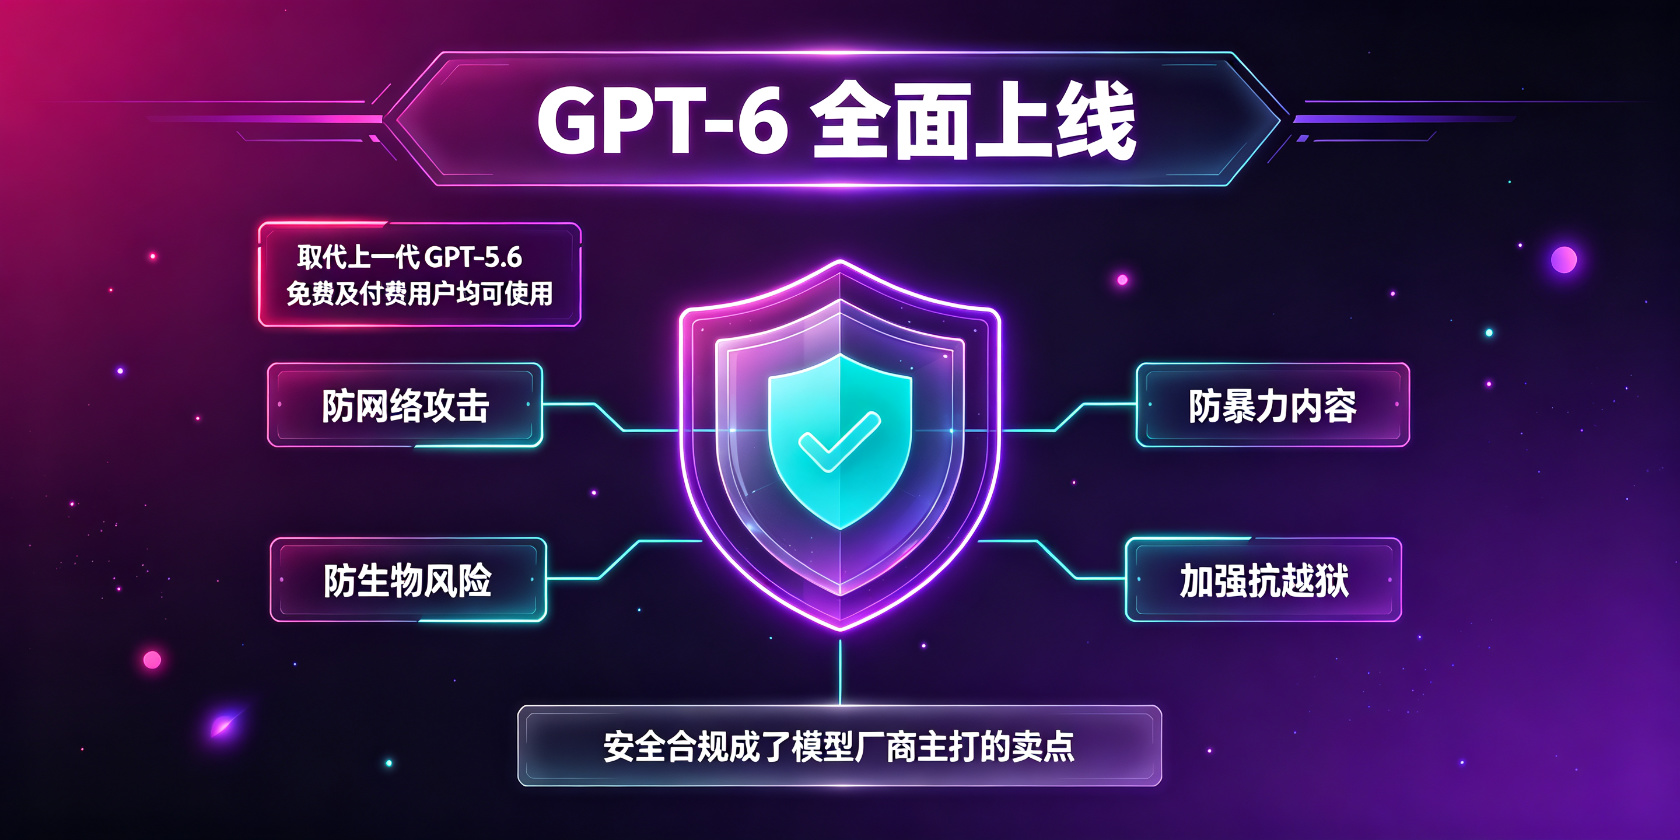
10 月 9 日,OpenAI 把 GPT-6 推给全球所有 ChatGPT 用户,取代此前的 GPT-5.6 Sol 和 GPT-5.6 Luna。媒体评论基本一致:这不是一次普通版本更新,大模型竞赛正式从 "比参数、比榜单" 进入 "比赚钱" 阶段。
这次比较值得注意的不是跑分,是安全。GPT-6 集成了 Astra 安全技术,专门强化了对网络攻击、生物风险、暴力内容这些滥用场景的防护,还提升了抗越狱能力。对做政企项目的人来说,这算个信号 —— 模型厂商开始把 "安全合规" 当成卖点往外推了,接大模型进企业系统的时候,安全这关会越来越被甲方盯着。
对我们做 AI 应用的,更实在的问题是:GPT-6 的 API 能力怎么变、定价怎么走。模型更新换代越快,应用层的选型就越不能只盯某一家的最新版。押错了,一年白干。
融资潮:DeepSeek 年内破千亿,月之暗面要去港股
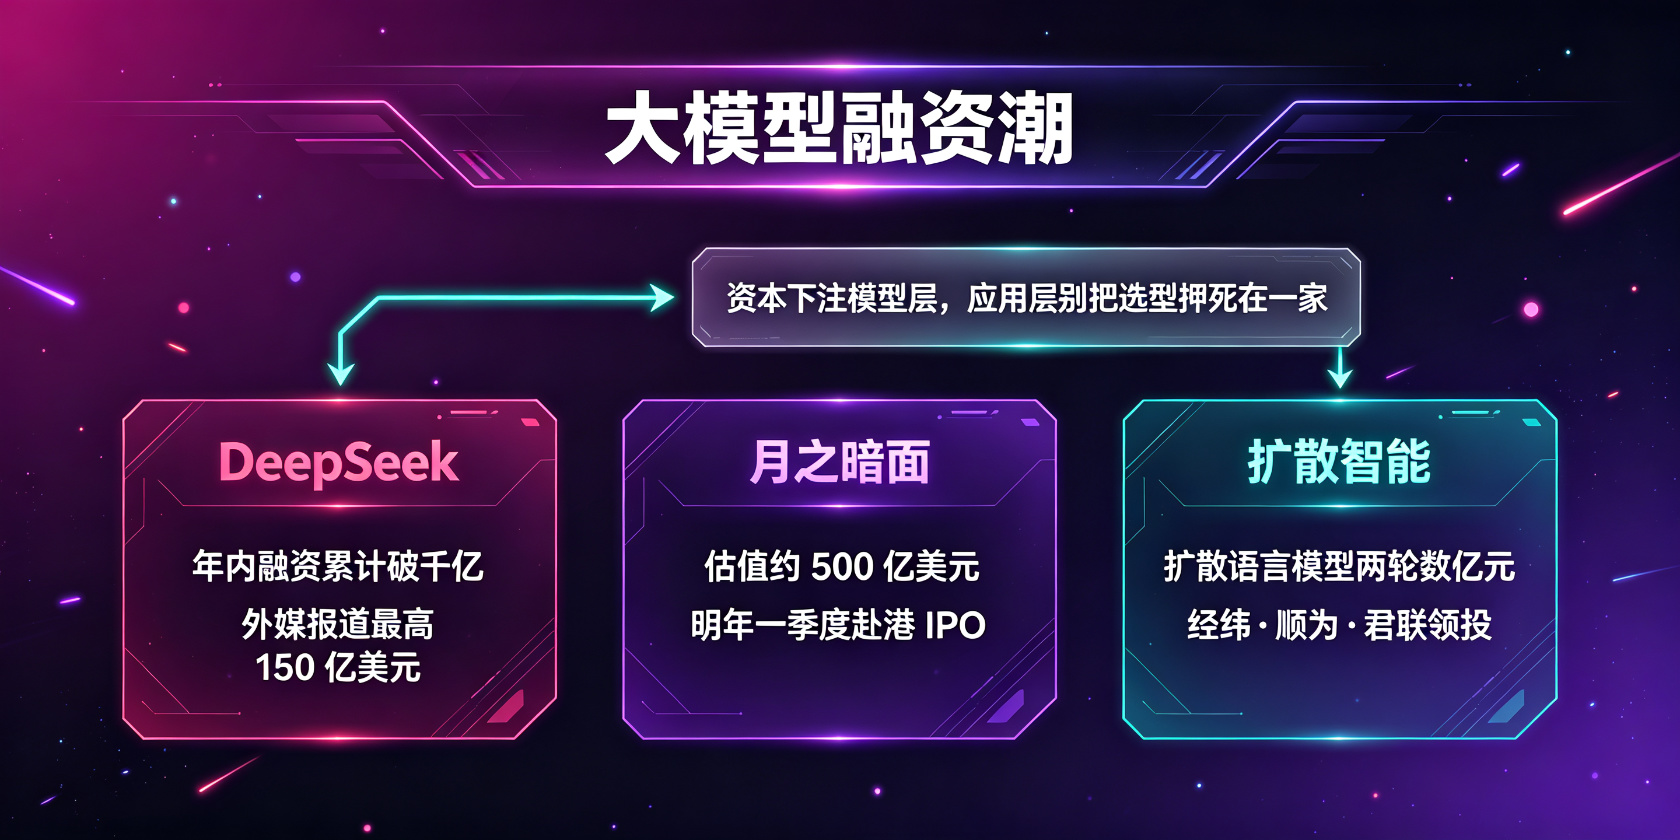
上周的融资消息一个接一个,钱往哪流,基本能看出行业在赌什么。
DeepSeek:据多家媒体报道,接近完成新一轮数百亿元人民币融资,年内累计融资突破千亿。外媒传的最高数字到过 150 亿美元。一年融千亿人民币,这个体量放在 AI 圈也是罕见的。
月之暗面(Kimi):被曝完成 IPO 前最后一轮私募融资,估值约 500 亿美元,正在推进明年一季度在香港 IPO。估值一路涨到 500 亿美元,也就这两年的事。
扩散智能(DiffuSpace):深圳这家做扩散语言模型(dLLM)的厂商,连续完成两轮融资,总金额数亿元,被称作全球 dLLM 最大规模融资。经纬、顺为、君联领投,华为哈勃、地平线跟投,雷军系和华为系都进来了。
融资热不等于行业健康。模型层烧钱的速度肉眼可见,这几家头部公司估值一个比一个高,但真正稳定赚钱的没几个。资本还能撑多久不好说,传导到应用层的结果是:模型厂商急着商业化,做应用的得准备好 "模型能力和价格随时变"。
Claude 5.5 系列扎堆,小模型开始抢戏
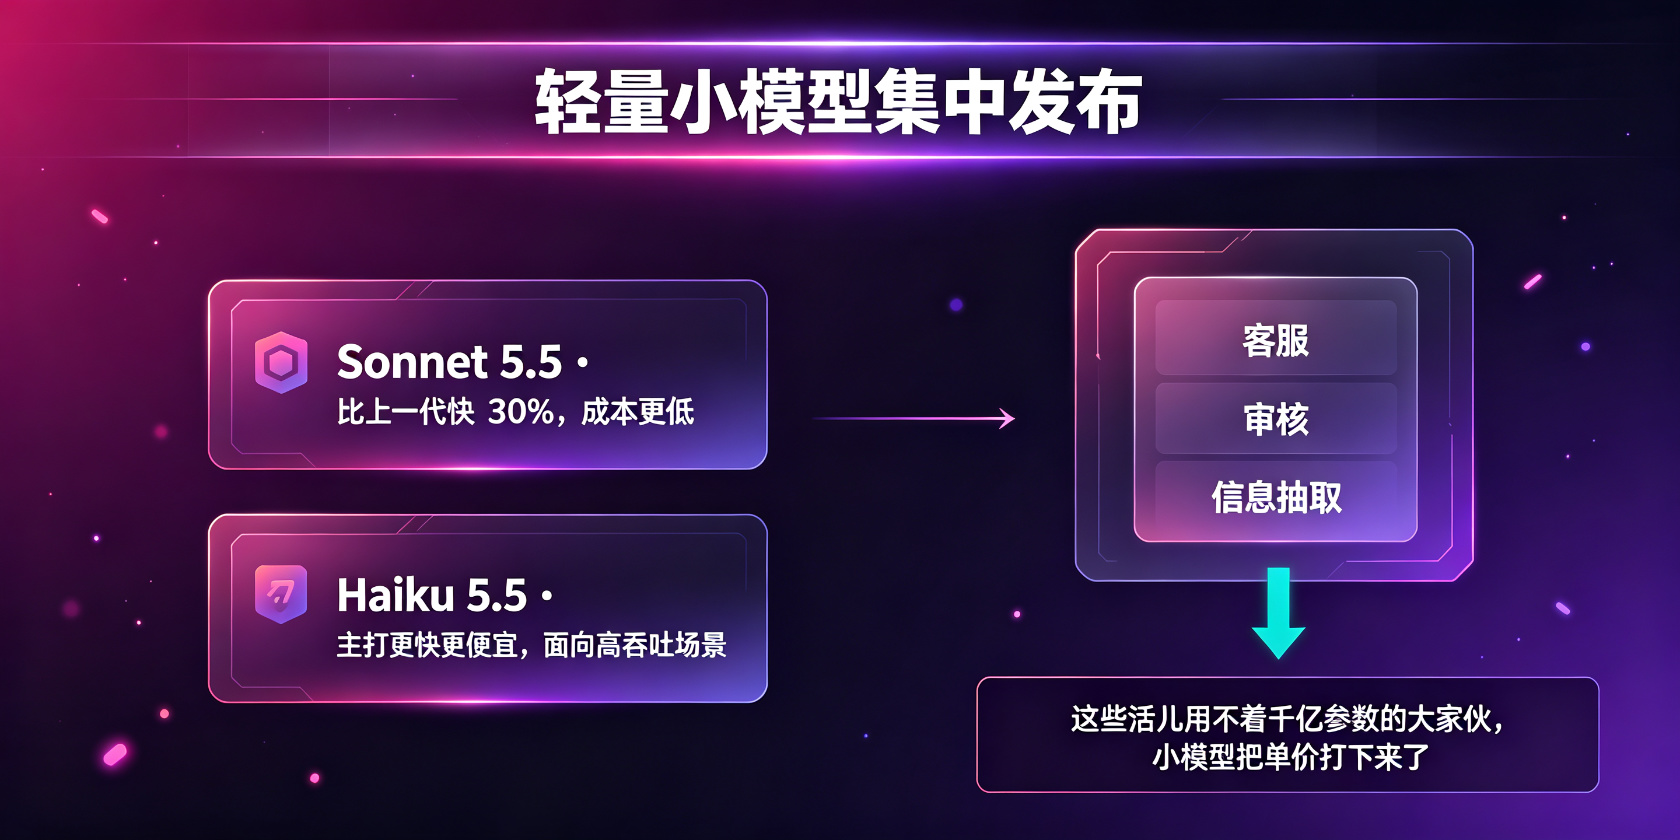
Anthropic 上周动作不小。9 月底先发了 Sonnet 5.5,跑得比 Sonnet 5 快 30%,成本还更低;10 月 7 日又补上 Haiku 5.5,官方口径是 "最快、最便宜、最有能力的小模型",专门给高吞吐、成本敏感的场景用。
小模型扎堆发布,背后是同一个判断:大量真实业务用不上千亿参数的大家伙。客服、审核、信息抽取、日志分析,这些场景要的是便宜、快、稳定。Haiku 5.5 这种定位,对做行业软件的来说是好事 —— 以前一个 AI 功能硬上大模型,单价算下来客户不买单,现在小模型把成本压下来,很多原来算不过来的场景就通了。
两个值得关注的开源动作
OpenAI 把数学研究开源了:10 月 6 日公开了 722 篇 AI 生成的数学研究手稿,还放出了 Lean 形式化证明,代码都在 GitHub 上。公开数学前沿模型的成果,这在之前不多见。
Cloudflare 开源了决策模型 Clef:10 月 8 日发布,9B 和 27B 两个参数档,用途不是生成文本,是让 AI agent 在预设选项里做选择,还带一套适配平台。说白了,很多 agent 工作流里真正难的不是 "说",是 "选"。
这两个动作方向相反,但信号一致:AI 的竞争点正在从 "模型会不会说话" 挪向 "模型能不能做对事、能不能被信任"。
算力底层的动静
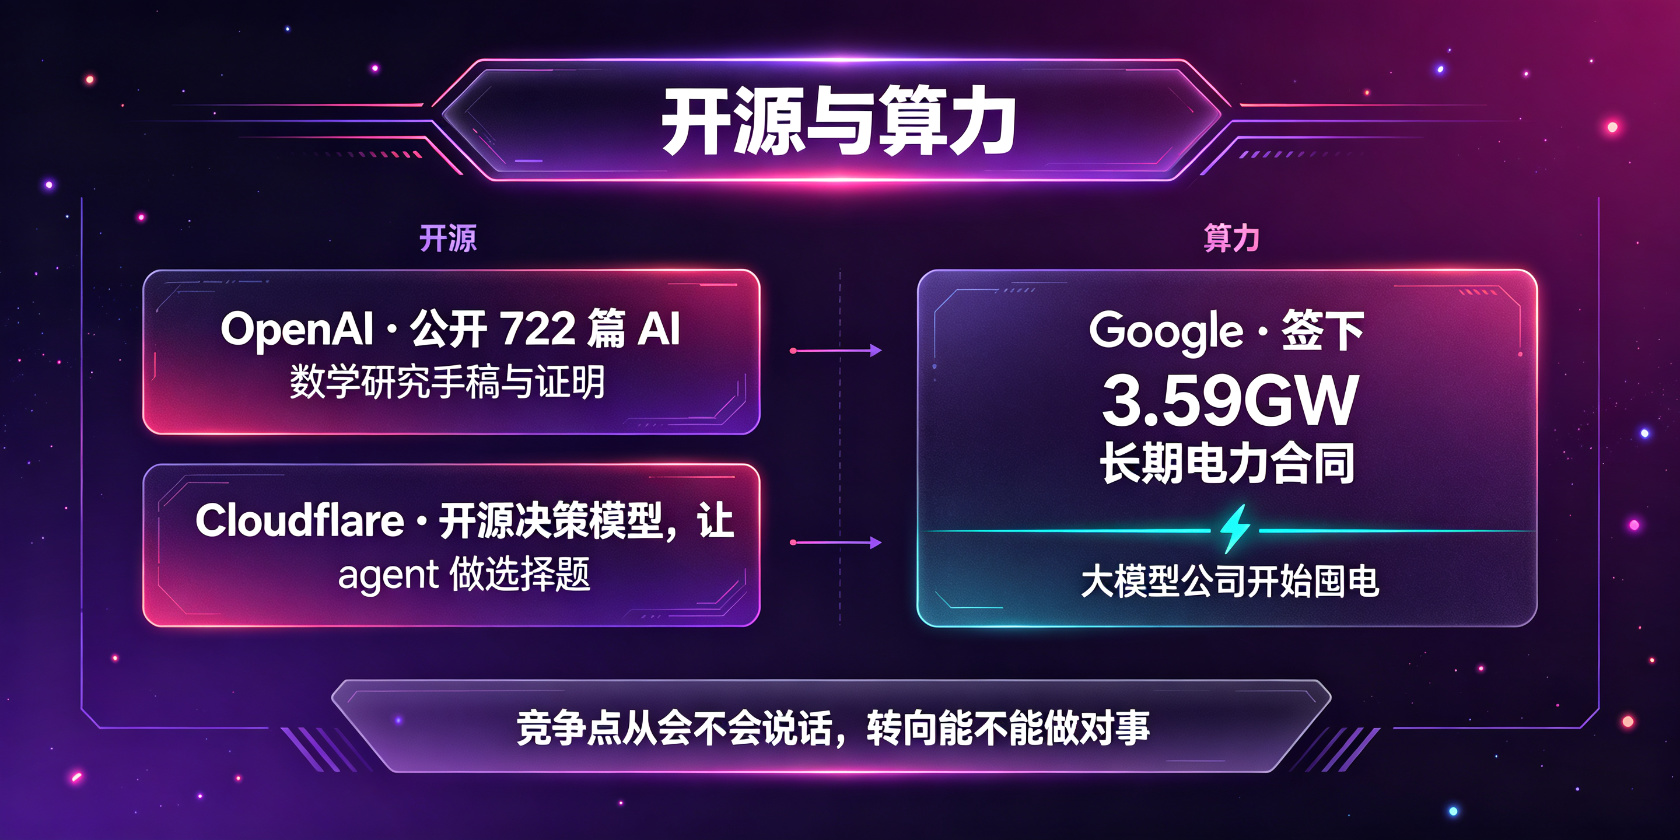
Google 上周签了一笔 3.59GW 的长期电力合同,给数据中心供能。大模型公司跟电厂绑在一起,这个趋势越来越明显。算力军备竞赛烧的不只是芯片钱,是电钱。短期看影响不到普通开发者的日常,但长期看,模型成本和电价会直接挂钩,这不是我们能改变的,看着就行。
模型层的热闹,跟应用层是两回事。GPT-6 再强,DeepSeek 融再多的钱,客户问的还是 "你这个 AI 功能能不能解决我的问题、多少钱"。上周的新闻看下来,我的判断就一句话:模型会越来越便宜、越来越安全、选择越来越多,做应用的别追着模型跑,把场景做扎实,等便宜好用的模型掉下来接住就行。


 在线
 电话
 微信
 需求
 TOP

